Sobre este trabajo: es el primer modelo que entreno. Vengo de la ingeniería de software, no de la investigación en IA, así que trabajé con una regla simple: ninguna decisión sin una medición. Las predicciones se escribieron antes de ver los resultados, los exámenes finales se abrieron una sola vez y aquí cuento también lo que no funcionó.
En corto
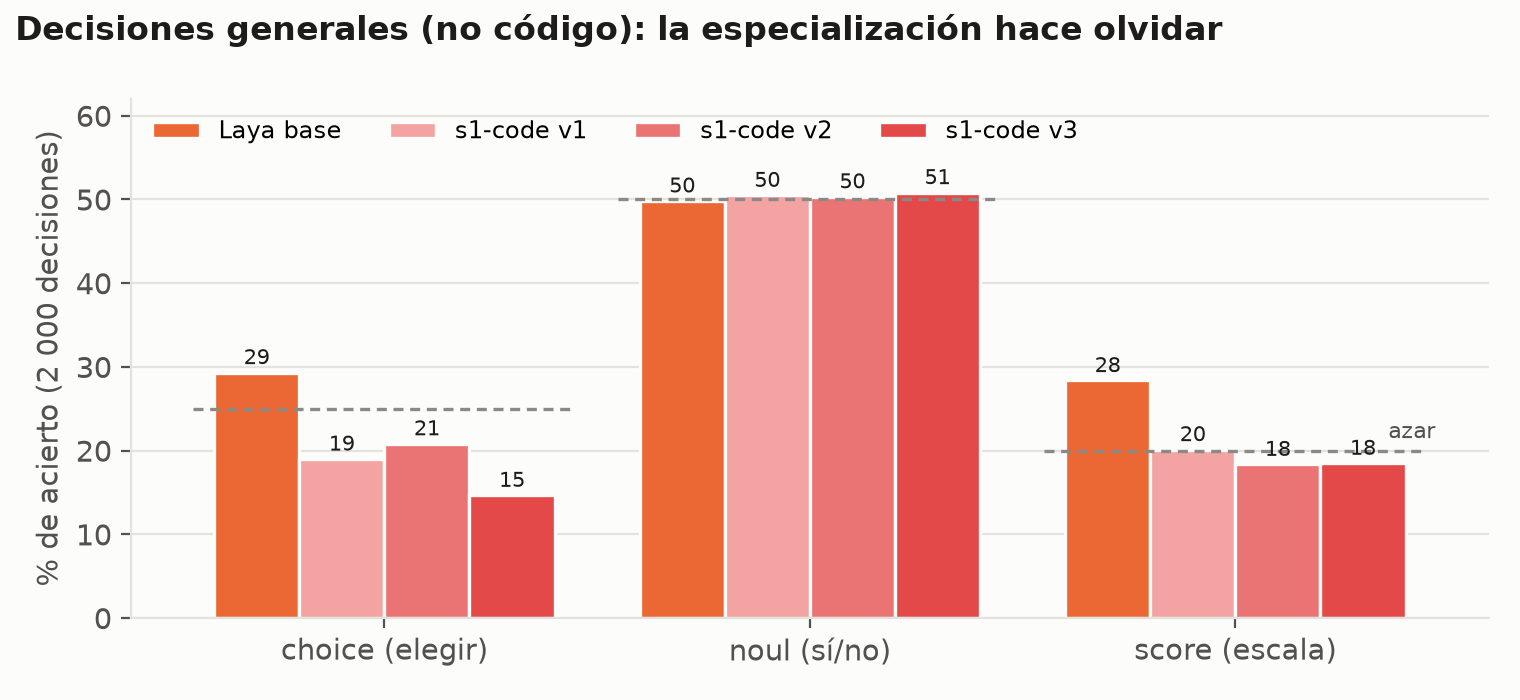
- Laya, un modelo System One abierto, no sabía juzgar código: acertó 1 de 20 búsquedas, como el azar. Lo medimos en una tarde antes de construir nada sobre él.
- Entrenamos nuestro propio modelo, s1-code, en tres versiones. La v3 acierta 161 de 197 búsquedas reales nunca vistas por sí sola, frente a 144 de la v1 (p = 0,002) y 152 de Qwen3-Embedding.
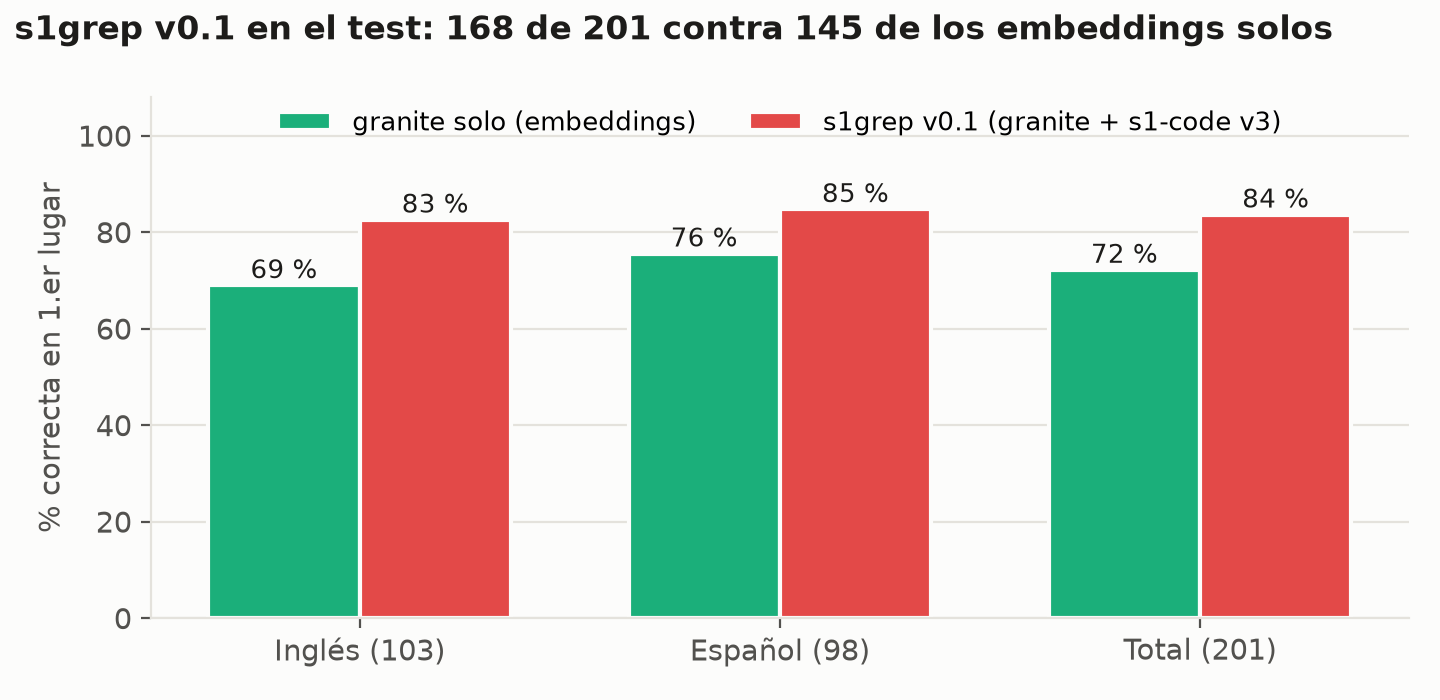
- Construimos s1grep, un buscador local en Rust: encuentra la función correcta en 1.er lugar en 168 de 201 búsquedas reales, contra 145 de los embeddings solos, en inglés y en español por igual.
- Lo llevamos de prototipo a producto en cinco versiones (0.2 a 0.5): nueve lenguajes, repositorios grandes buscables en minutos, búsqueda por palabras donde ayuda, un proceso en segundo plano que nadie tiene que arrancar y una herramienta para agentes de programación. El examen se mantuvo en 168 de 201 en cada versión.
- No todo salió bien: la v3 no supera con seguridad a la v2, los modelos grandes con GPU siguen siendo mejores jueces y, en otros lenguajes, el juez ayuda en Java pero empeora JavaScript y Go. Todo eso está medido y contado aquí.
La pregunta
Los agentes de programación y las personas pierden mucho tiempo buscando dónde está algo en un repositorio. grep encuentra palabras, no intenciones: si preguntas "dónde se reintenta un pago fallido", la función puede llamarse send_with_retry y no contener ninguna palabra de tu pregunta.
Herramientas como jevgrep resuelven esto enviando tu código a un modelo en la nube. Nuestra pregunta fue otra:
¿Se puede construir una alternativa local, abierta y bilingüe (inglés y español) que encuentre código por lo que hace usando modelos System One y funcione en una CPU común?
La respuesta corta es sí, con matices. Este artículo cuenta los 18 pasos que llevaron hasta ahí, con lo que funcionó y lo que no.
Qué es un modelo System One
Un modelo System One no escribe texto. Recibe un documento y preguntas tipadas (elegir entre opciones, verdadero o falso, o una escala) y devuelve probabilidades en una sola pasada. Por eso es rápido, no "alucina" y sus respuestas se pueden calibrar: un 90 % debería acertar 9 de cada 10 veces.
s1-code recibe una función y una pregunta, y responde con la probabilidad de que esa función responda la búsqueda:
[CLS] noul question: This code answers the search: dónde se reintenta un pago fallido [SEP]
      [MASK] no  [MASK] sí [SEP]
billing/gateway/client.py
GatewayClient.send_with_retry

def send_with_retry(self, document, attempts=3): ... [SEP]
→ sí: 0,93
Partimos de Laya (Convai Innovations, Apache 2.0), un modelo System One multilingüe de 322 millones de parámetros. s1-code es Laya ajustado para una sola tarea: decidir si un código responde una búsqueda. Técnicamente es un System One usado en el papel de reranker.
Fase 1 · Medir antes de construir
¿Laya entiende código?
Antes de escribir el buscador hicimos una prueba barata: 20 preguntas sobre 1 531 funciones de repositorios privados de servicios backend en Python. Un buscador por palabras (BM25) eligió 25 candidatas y Laya las ordenó con cuatro formas distintas de preguntar.
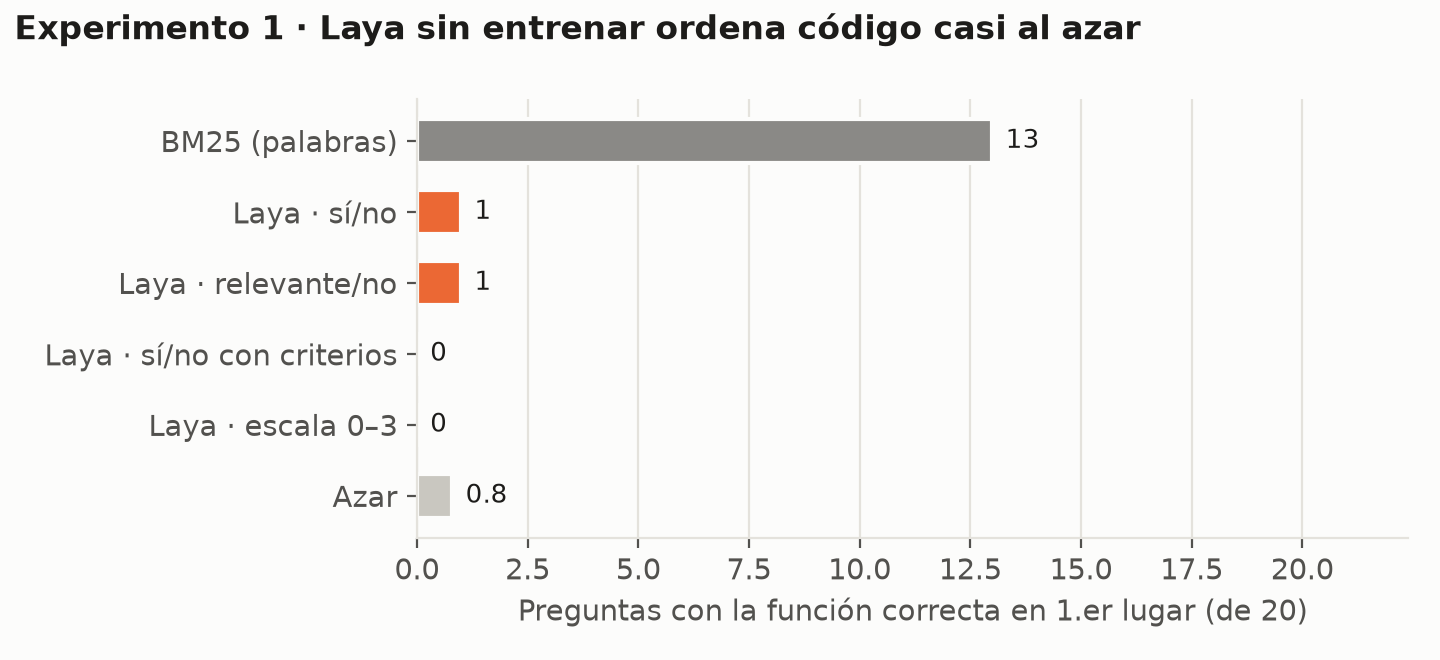
Conclusión: no construir sobre Laya tal cual. Esa prueba de 13 minutos evitó semanas de trabajo sobre un modelo que no servía para esto.
¿Los embeddings encuentran el código?
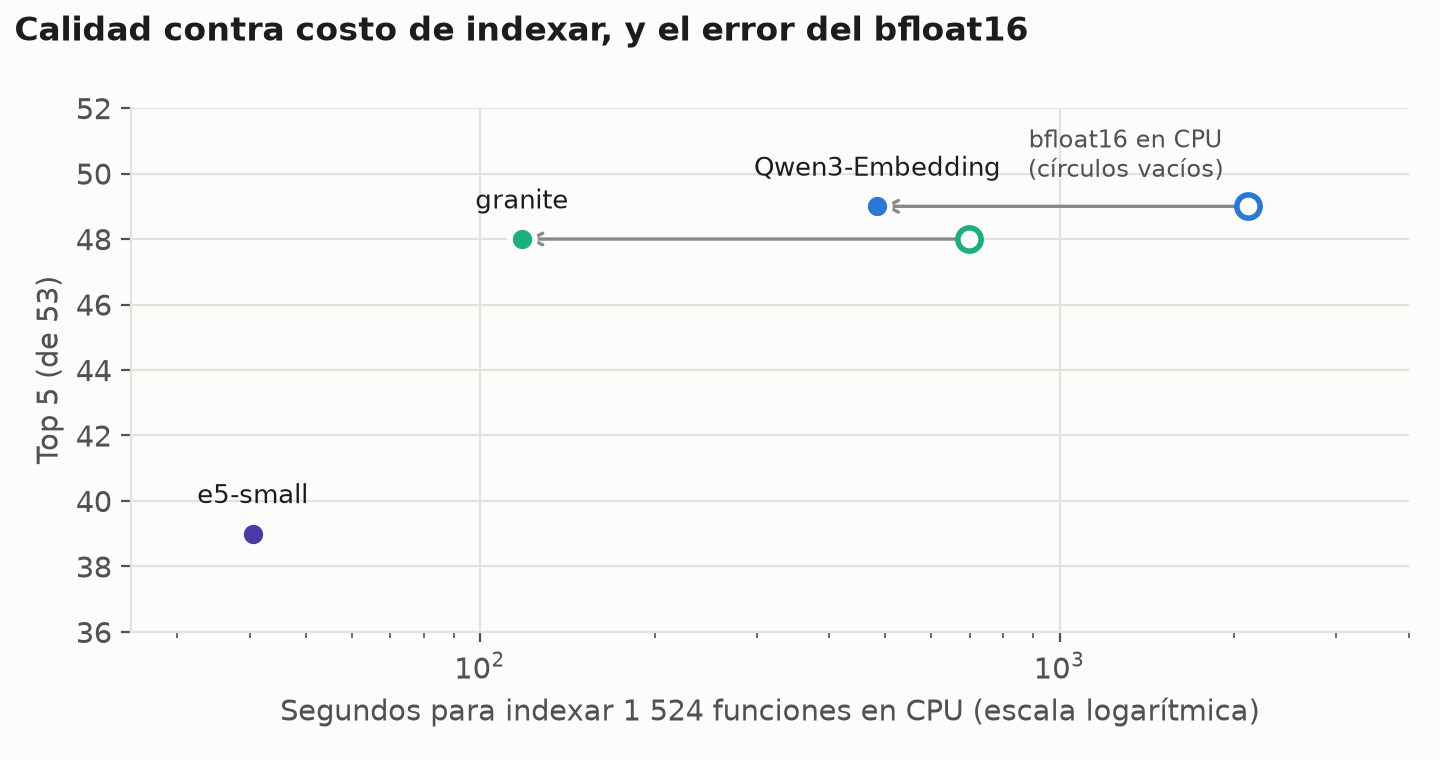
Armamos un examen de 53 preguntas reales sacadas de commits y comparamos BM25, tres modelos de embeddings, su fusión con BM25 y dos rerankers, buscando en todas las funciones de los repositorios.
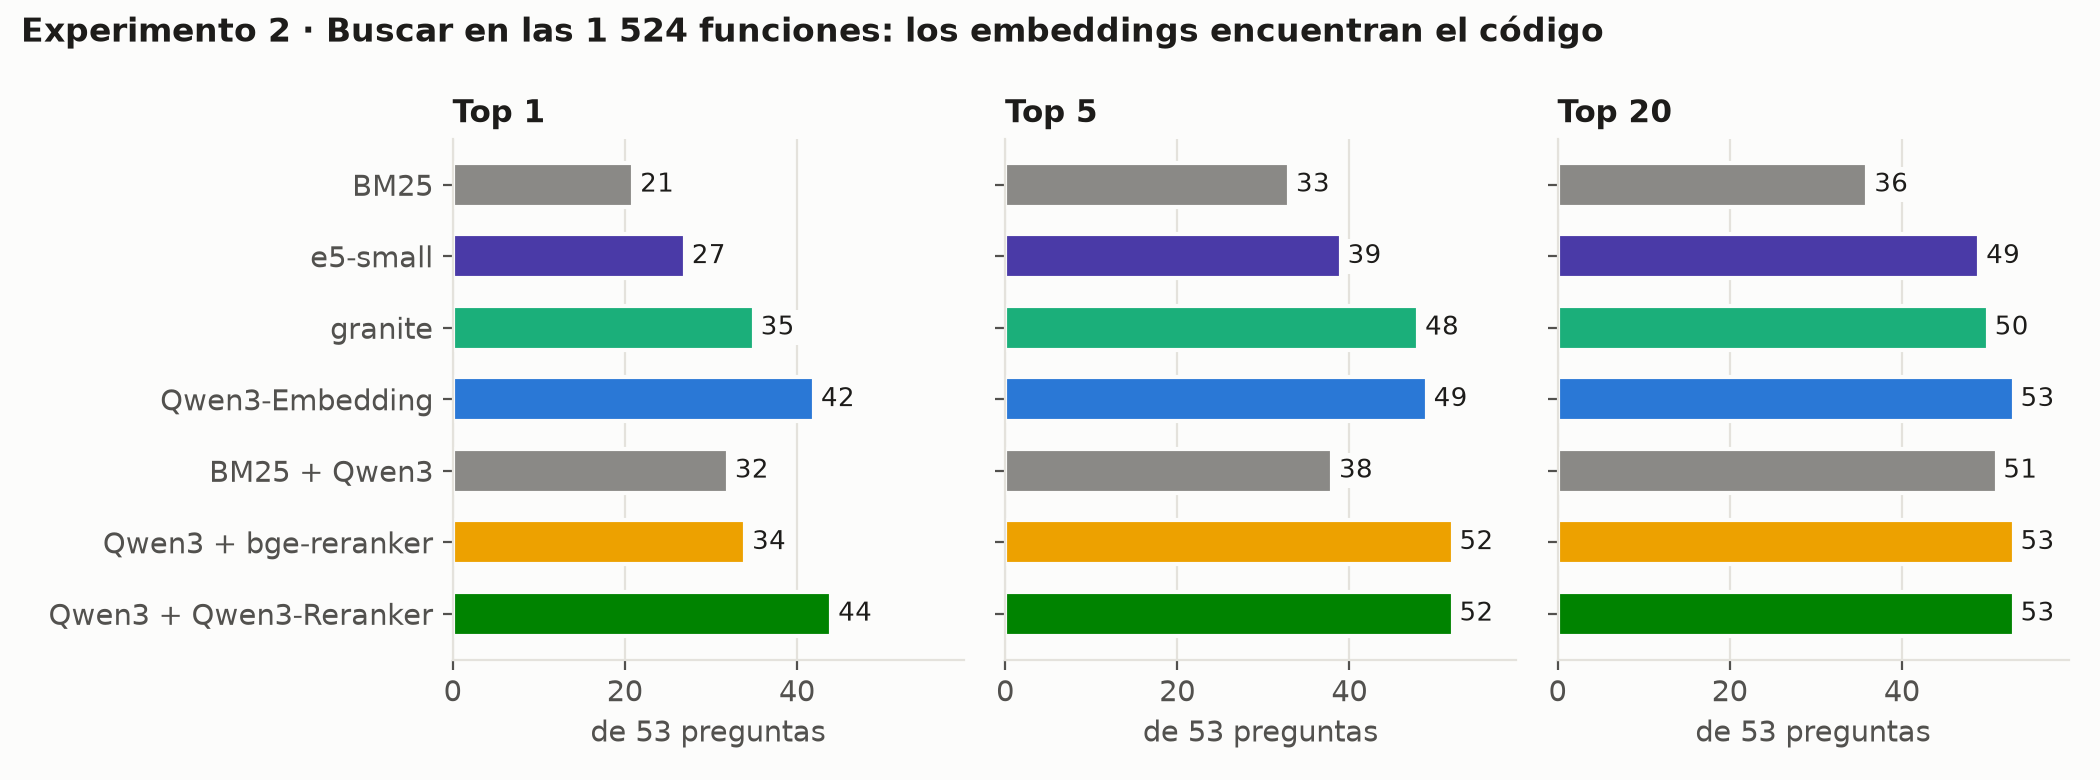
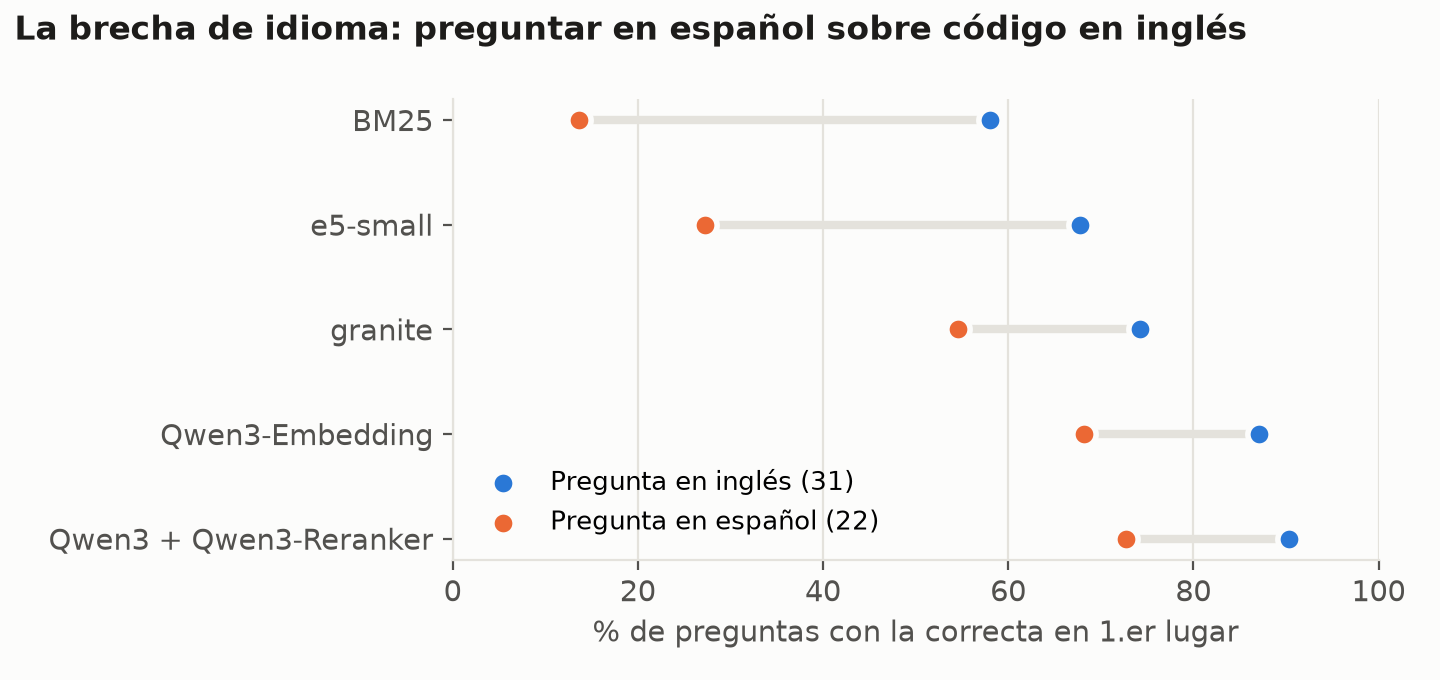
Revisamos también qué existía: hay buscadores semánticos abiertos (ck, osgrep y otros), pero ninguno tiene un juez System One local entrenado para código. Ese fue el hueco que decidimos llenar.
Fase 2 · Sacar el modelo de Python
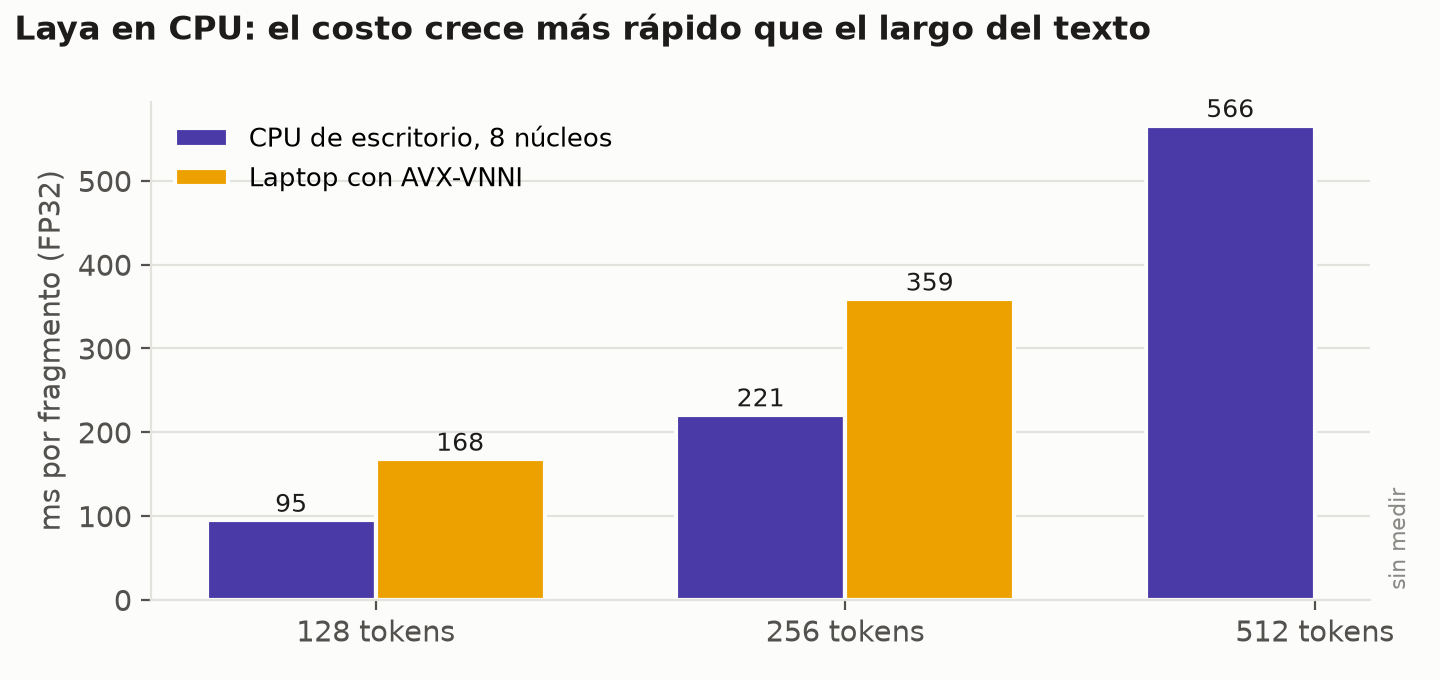
Para que el producto fuera un solo binario, sin Python, había que correr el modelo con ONNX Runtime desde Rust. Cuatro hallazgos:
- El exportador oficial estaba roto: fijaba el largo del texto en 16 tokens y fallaba con cualquier texto más largo. Con el exportador dynamo de PyTorch, ONNX coincide con el original en las 14 preguntas de prueba.
- INT8 no acelera: la cuantización dinámica lleva todas las respuestas a 0,5 y la de solo pesos conserva la calidad pero es más lenta en CPU. Nos quedamos con float32.
- El motor en Rust da lo mismo que Python: tokens idénticos y probabilidades a ±0,0006, también en Windows. Cada implementación nueva lleva su prueba de paridad.
- El error del bfloat16: tres modelos venían en bfloat16 y la CPU no tiene instrucciones para ese formato. En float32 indexan 5,8 veces más rápido con el mismo resultado.
Fase 3 · Construir los datos
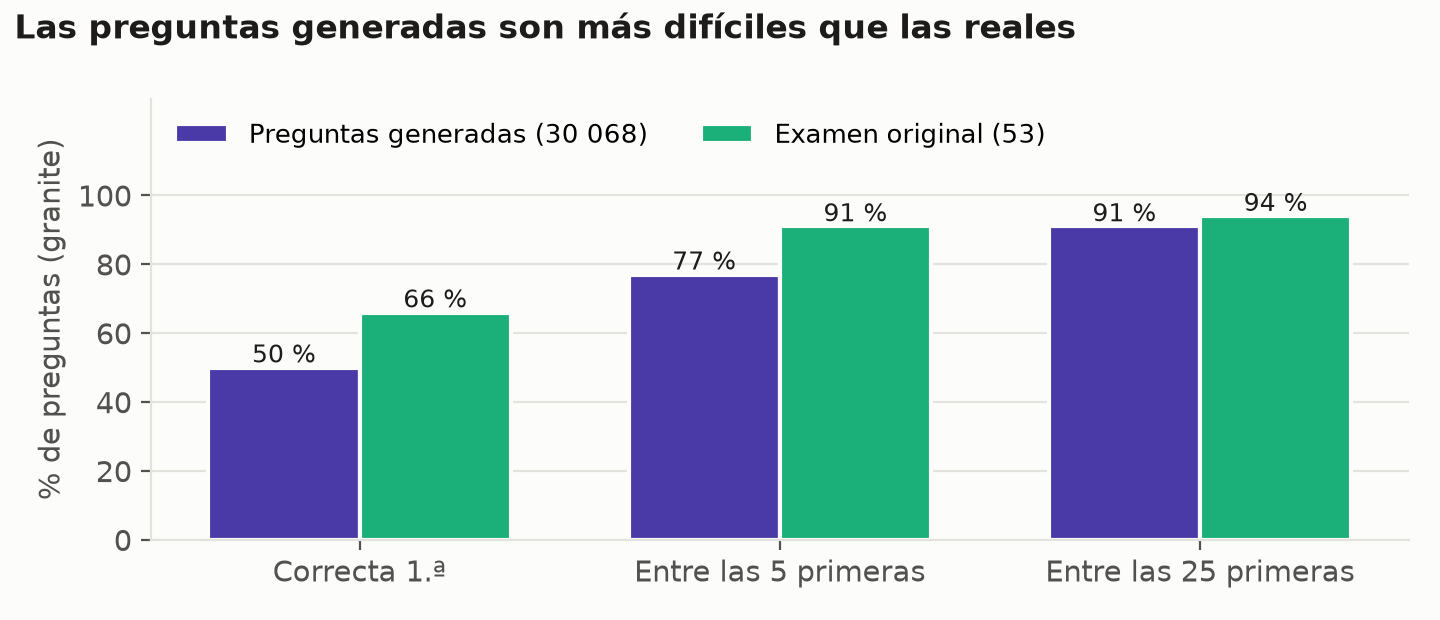
Entrenar un juez necesita miles de pares "búsqueda → función correcta". Los generamos "al revés": se elige una función y un modelo abierto (Qwen3-8B) escribe la búsqueda que haría alguien que la necesita, en inglés o en español y en uno de seis estilos. Un filtro descarta las que repiten el nombre de la función.
| Datos de la v1 | Cantidad |
|---|---|
| Repositorios públicos de Python con licencia permisiva | 306 |
| Funciones únicas, sin tests ni ejemplos | 799 635 |
| Preguntas aceptadas (83 %) | 30 068 |
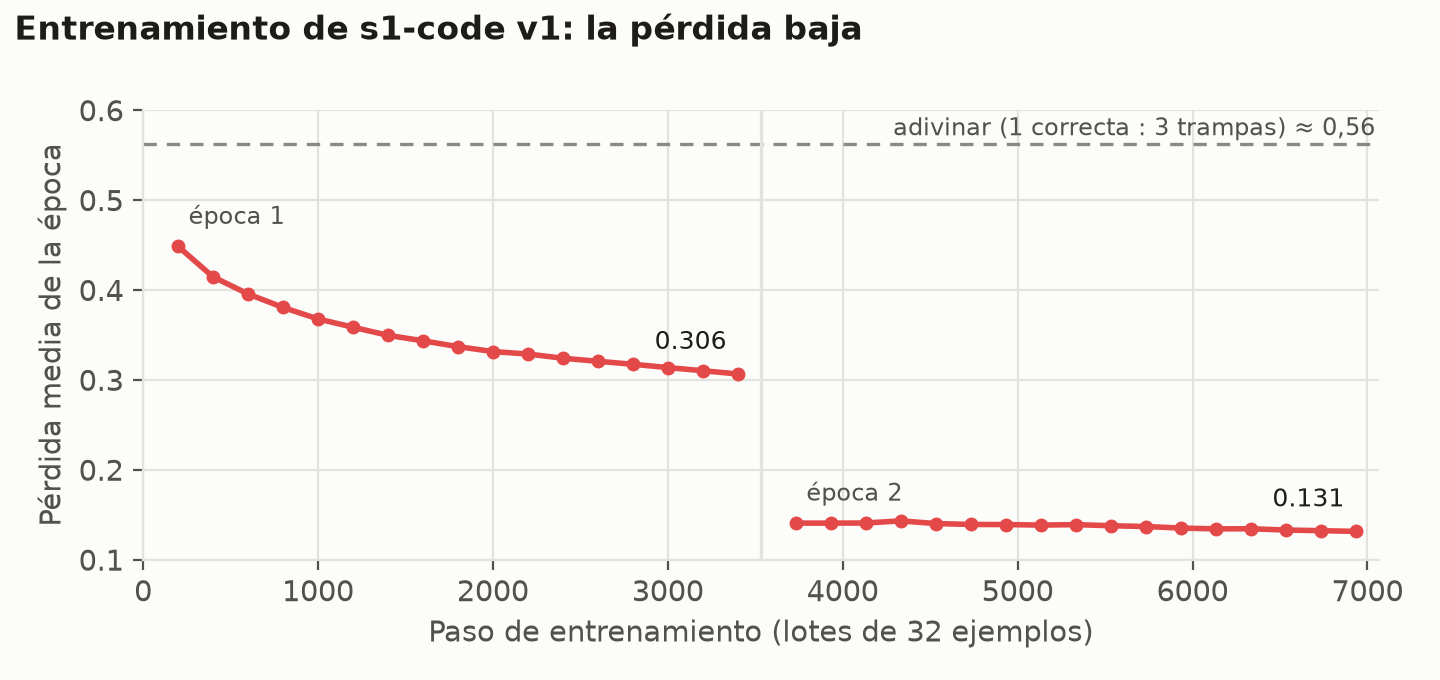
| Ejemplos de entrenamiento (1 correcta y 3 trampas por pregunta) | 113 008 |
| Preguntas de validación, de 16 repositorios nunca vistos | 400 |
Revisar dos muestras de 50 preguntas a mano, que costaron centavos, detectó frases de plantilla, tests colados y preguntas genéricas. Corregirlas antes de generar las 36 000 subió la aceptación de 80 % a 87 %.
Para enseñarle a decir "no", cada pregunta lleva trampas difíciles: las funciones más parecidas del mismo repositorio que no son la correcta.
Fase 4 · s1-code v1
Ajuste fino de Laya multilingüe con la receta de sus autores, 2 épocas en una GPU NVIDIA L4 en la nube (93 minutos) y calibración con 1 000 ejemplos apartados. Antes de entrenar fijamos el criterio: superar a granite solo (35 de 53) y la meta: 44.
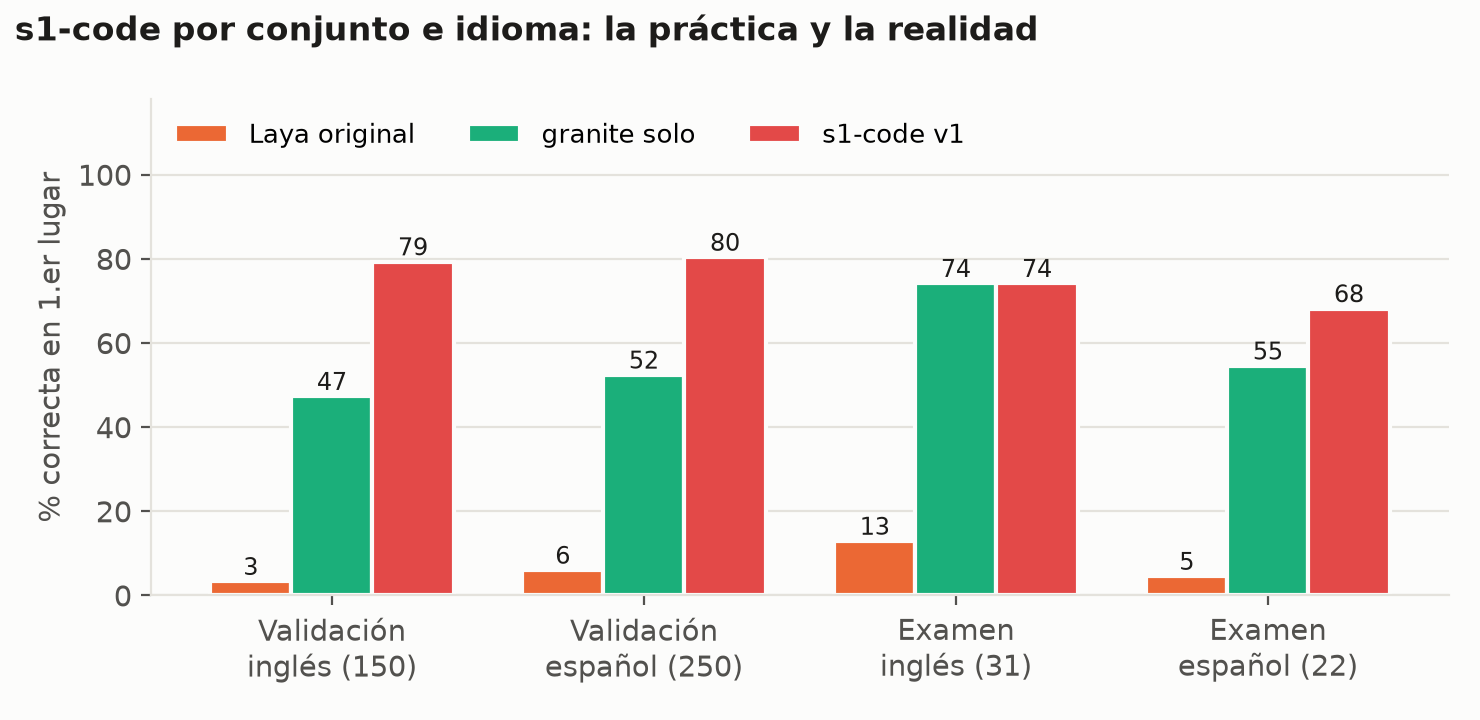
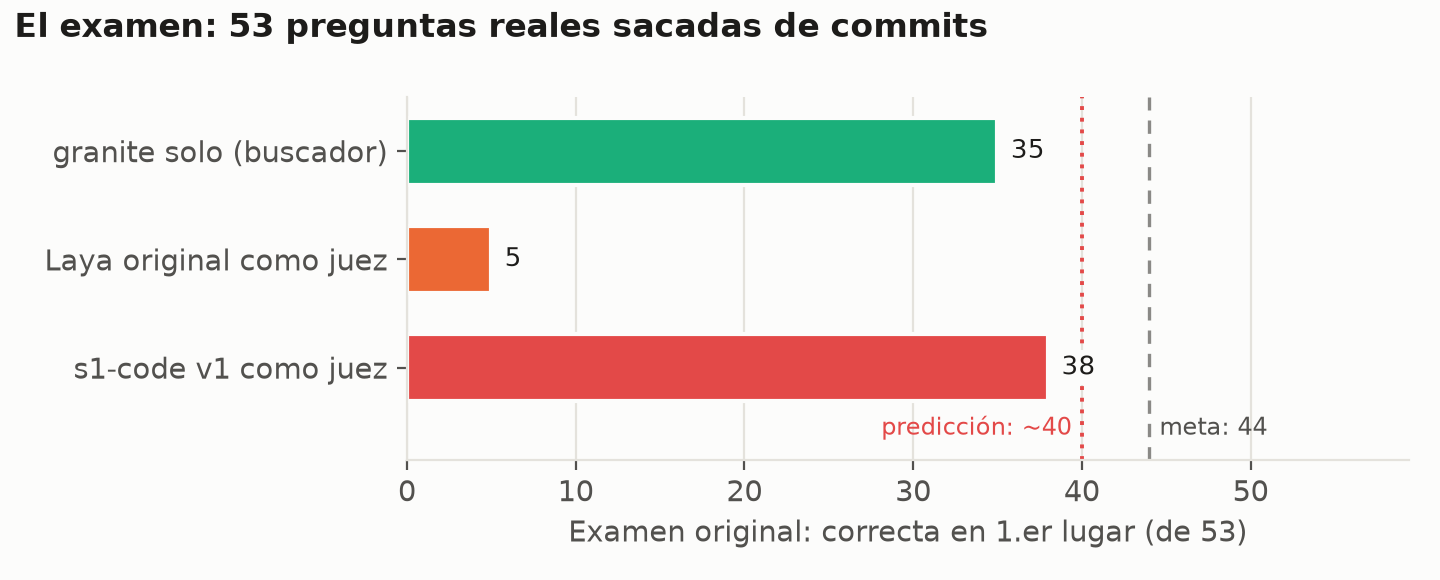
Después hicimos el examen más grande: 202 preguntas reales divididas en dev (100, para decidir) y test (102, se abre una sola vez). Y cambiamos de rival: un juez en cascada tiene que ganarle al buscador barato más fuerte, Qwen3-Embedding, no al más débil. Con ese rival, la ventaja de la v1 dejó de ser segura.
Fase 5 · s1-code v2: más datos, paridad exacta
La v2 sumó fuentes con preguntas escritas por personas y licencia verificada: mensajes de commit (CommitPackFT), issues ligados a la función corregida (SWE-bench, SWE-Gym, SWE-smith), búsquedas humanas (CoSQA) y funciones de repositorios privados de la organización, filtradas por secretos y datos personales. Cada pregunta recibió una gemela en el otro idioma.
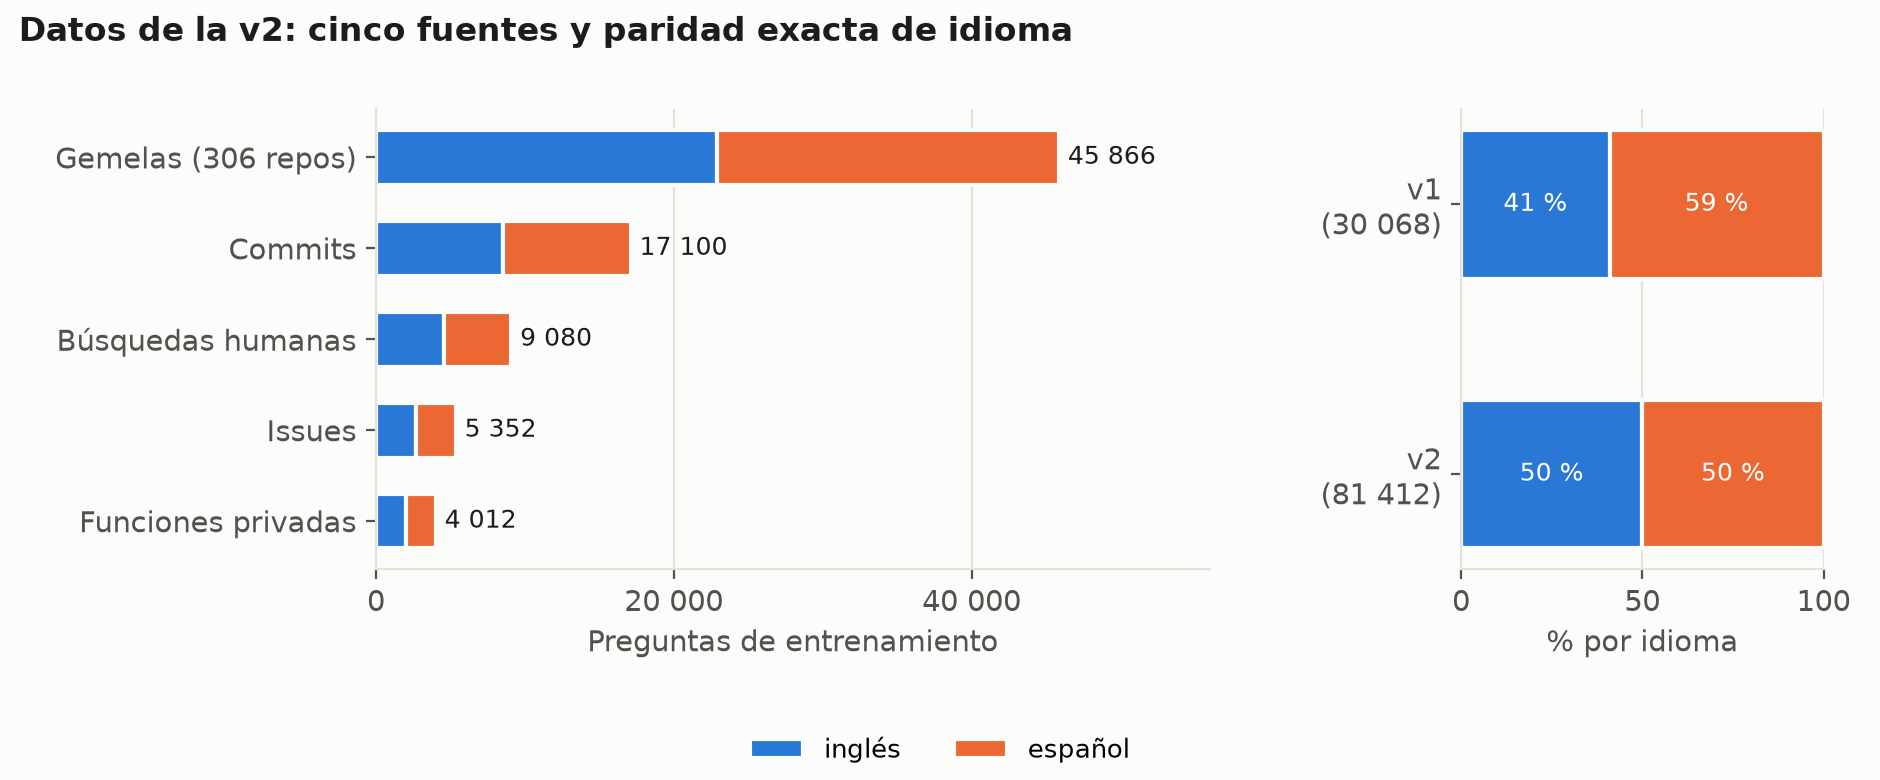
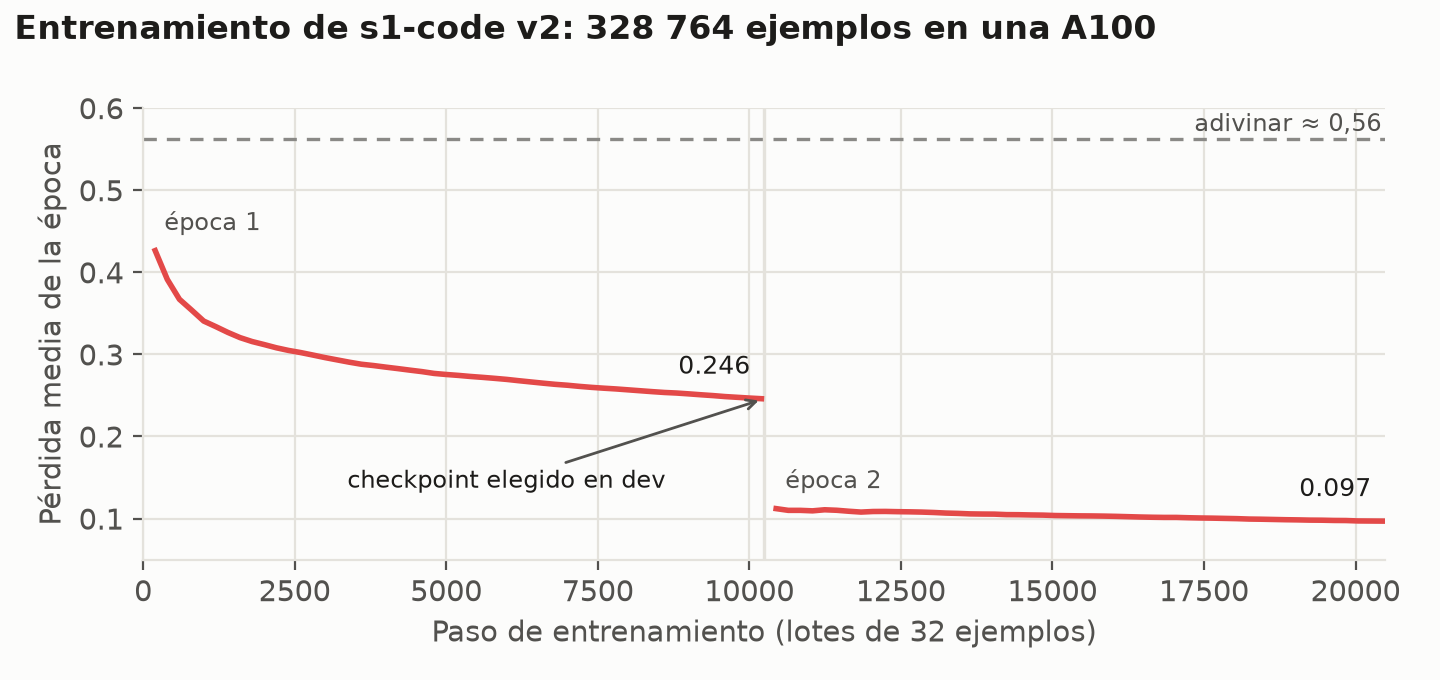
En validación la v2 parecía muy superior (315 contra 269 de 400). Al desglosar por tipo de pregunta apareció un atajo: en las preguntas de CoSQA acertaba el 100 %, porque reconocía el estilo de la respuesta correcta, no la búsqueda.
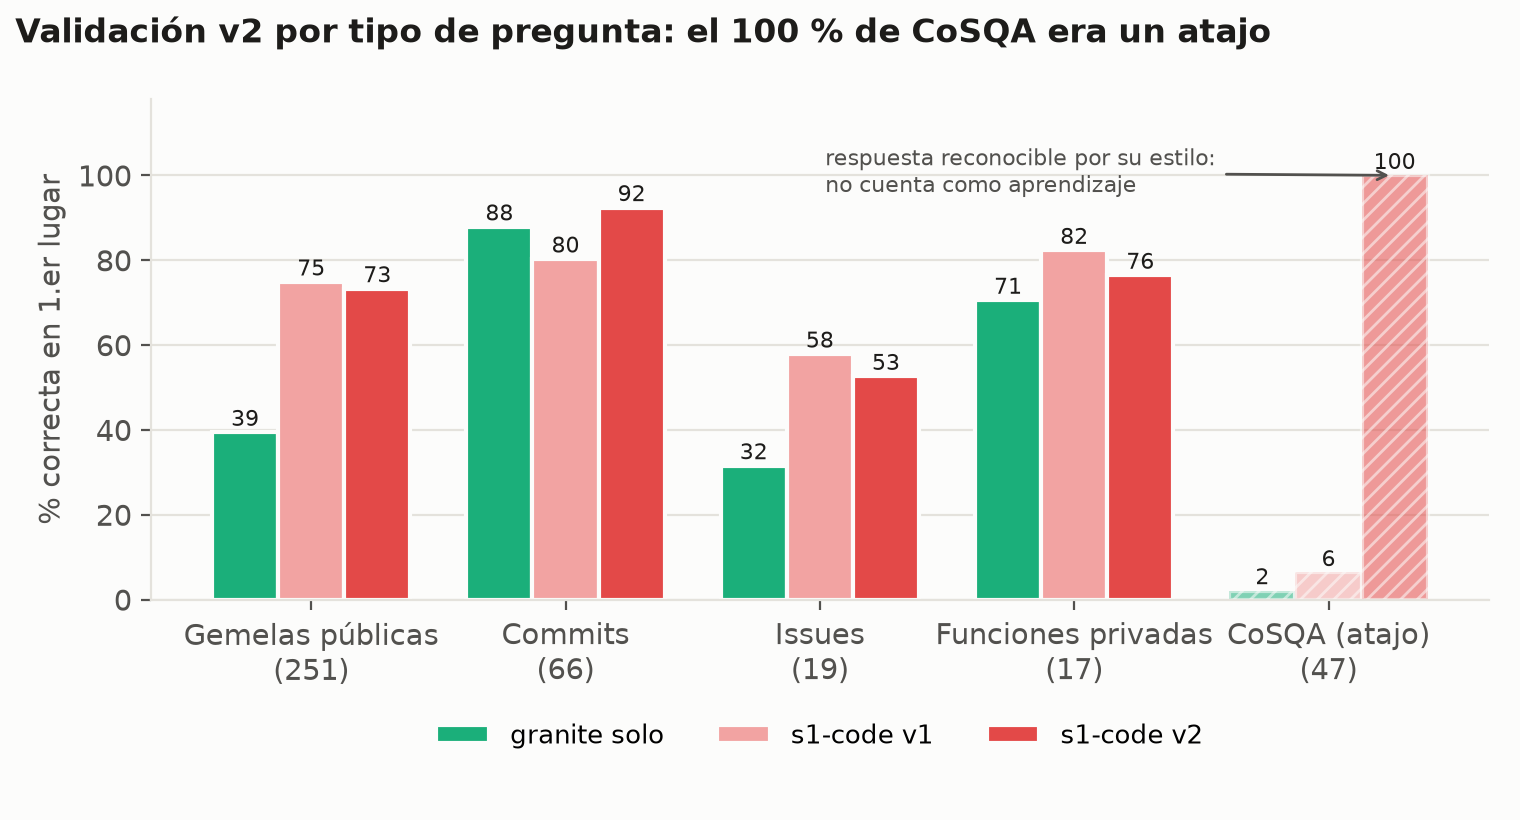
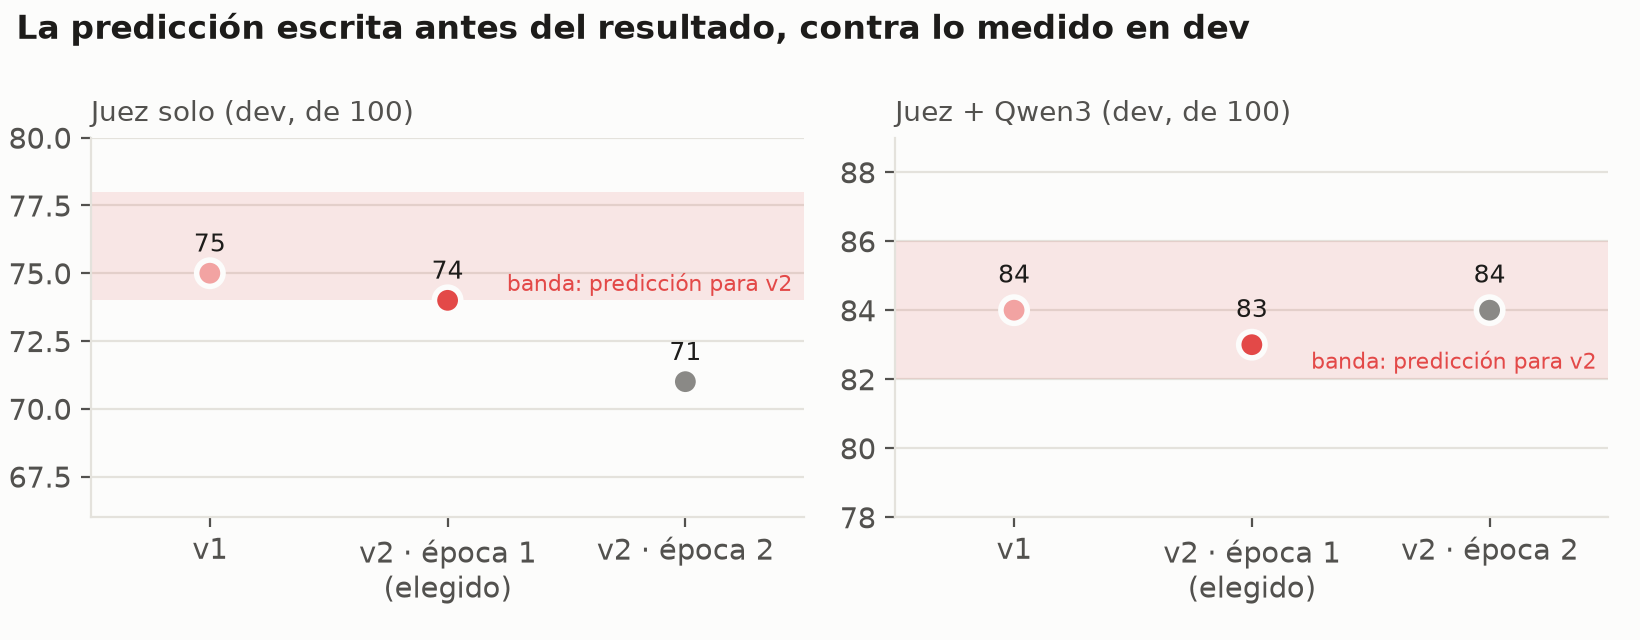
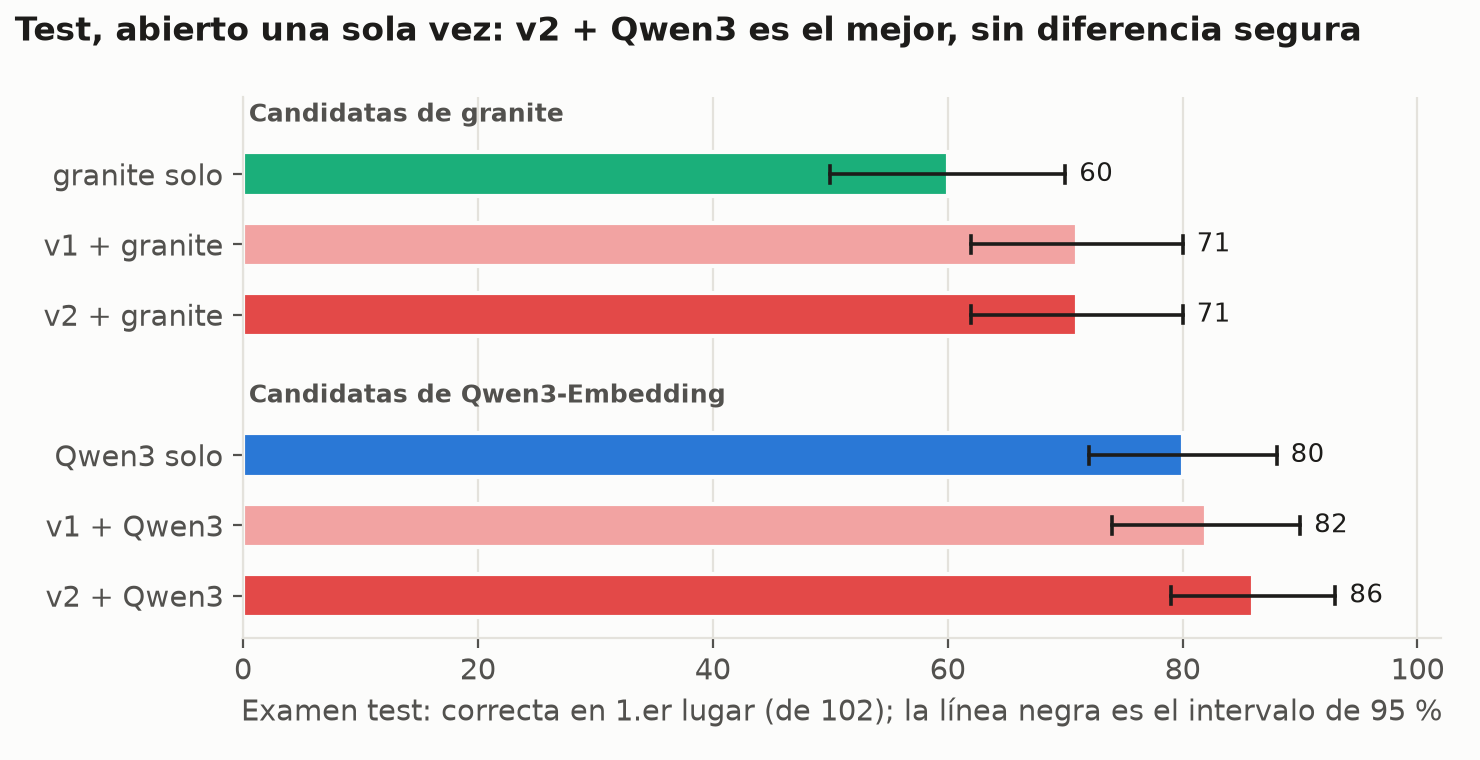
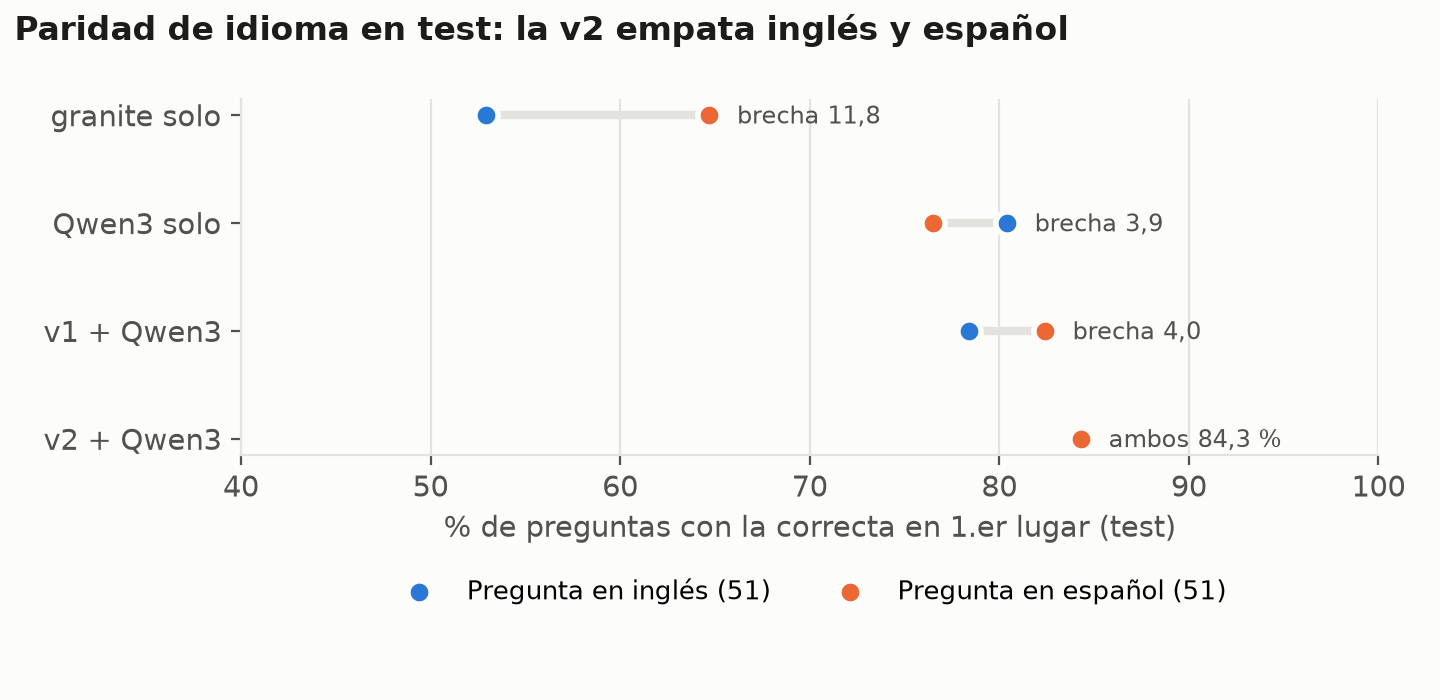
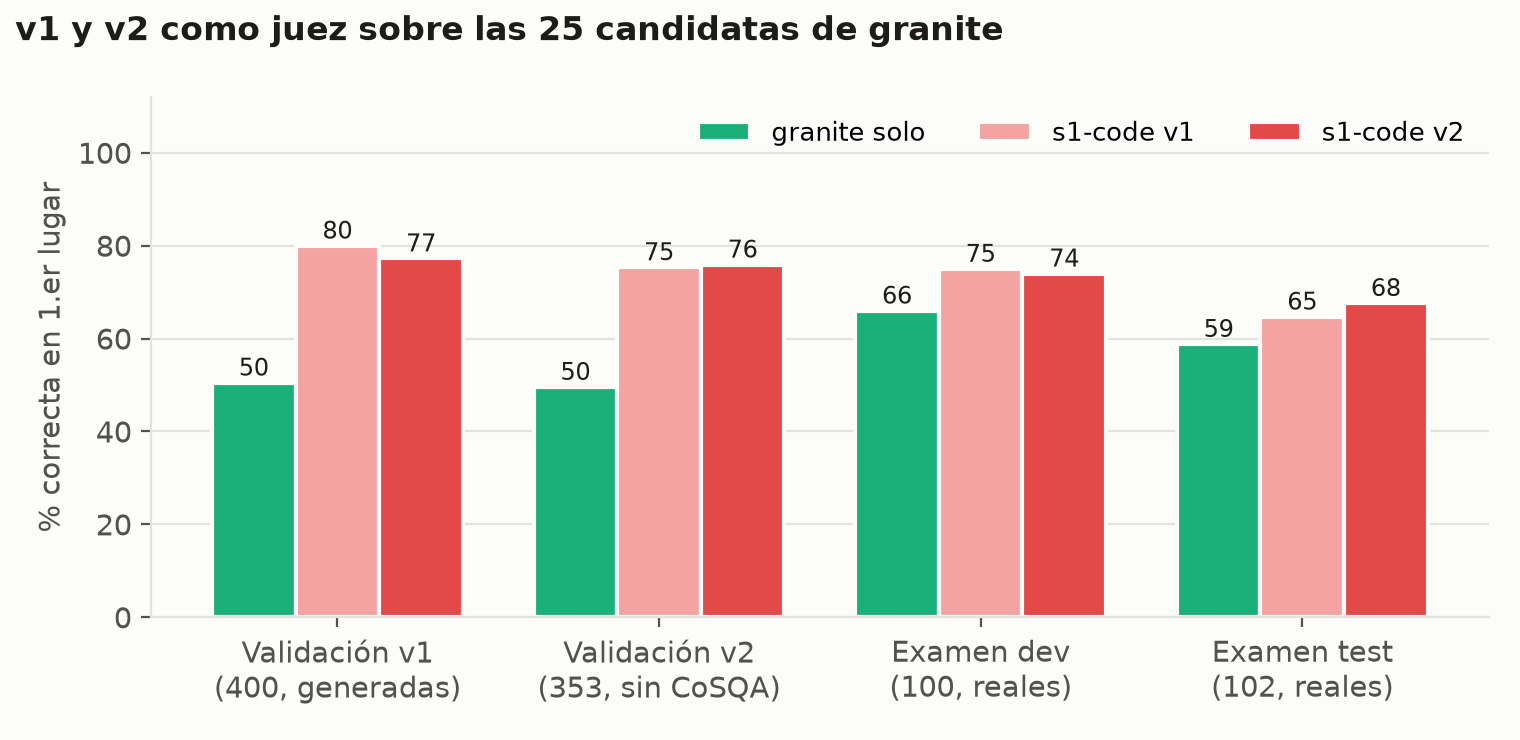
Veredicto honesto de la v2: fue un buen trabajo de investigación y un empate como modelo. Lo que mejoró de verdad fue nuestra capacidad de saberlo.
Fase 6 · s1-code v3: un maestro y control de memorización
Analizamos los 25 fallos de la v2: 12 dejaban la correcta en 2.º lugar y 9 se confundían con un método hermano de la misma clase. Probamos cuatro candidatos a maestro con las mismas preguntas. El mejor fue Qwen3-Reranker-4B (89 de 100 en dev); el más llamativo, Nimble de 9B, quedó por debajo. Elegir maestro con una prueba costó menos de 1 USD.
La v3 se entrenó con:
- 72 332 grupos de 1 correcta y 7 trampas sacadas del buscador real (Qwen3-Embedding), con paridad exacta de idioma.
- Una pérdida que pone a competir la correcta contra sus trampas.
- Notas del maestro en 20 000 grupos, mezcladas 50/50 con las etiquetas reales.
- Control de memorización cada 1 000 pasos y parada temprana.
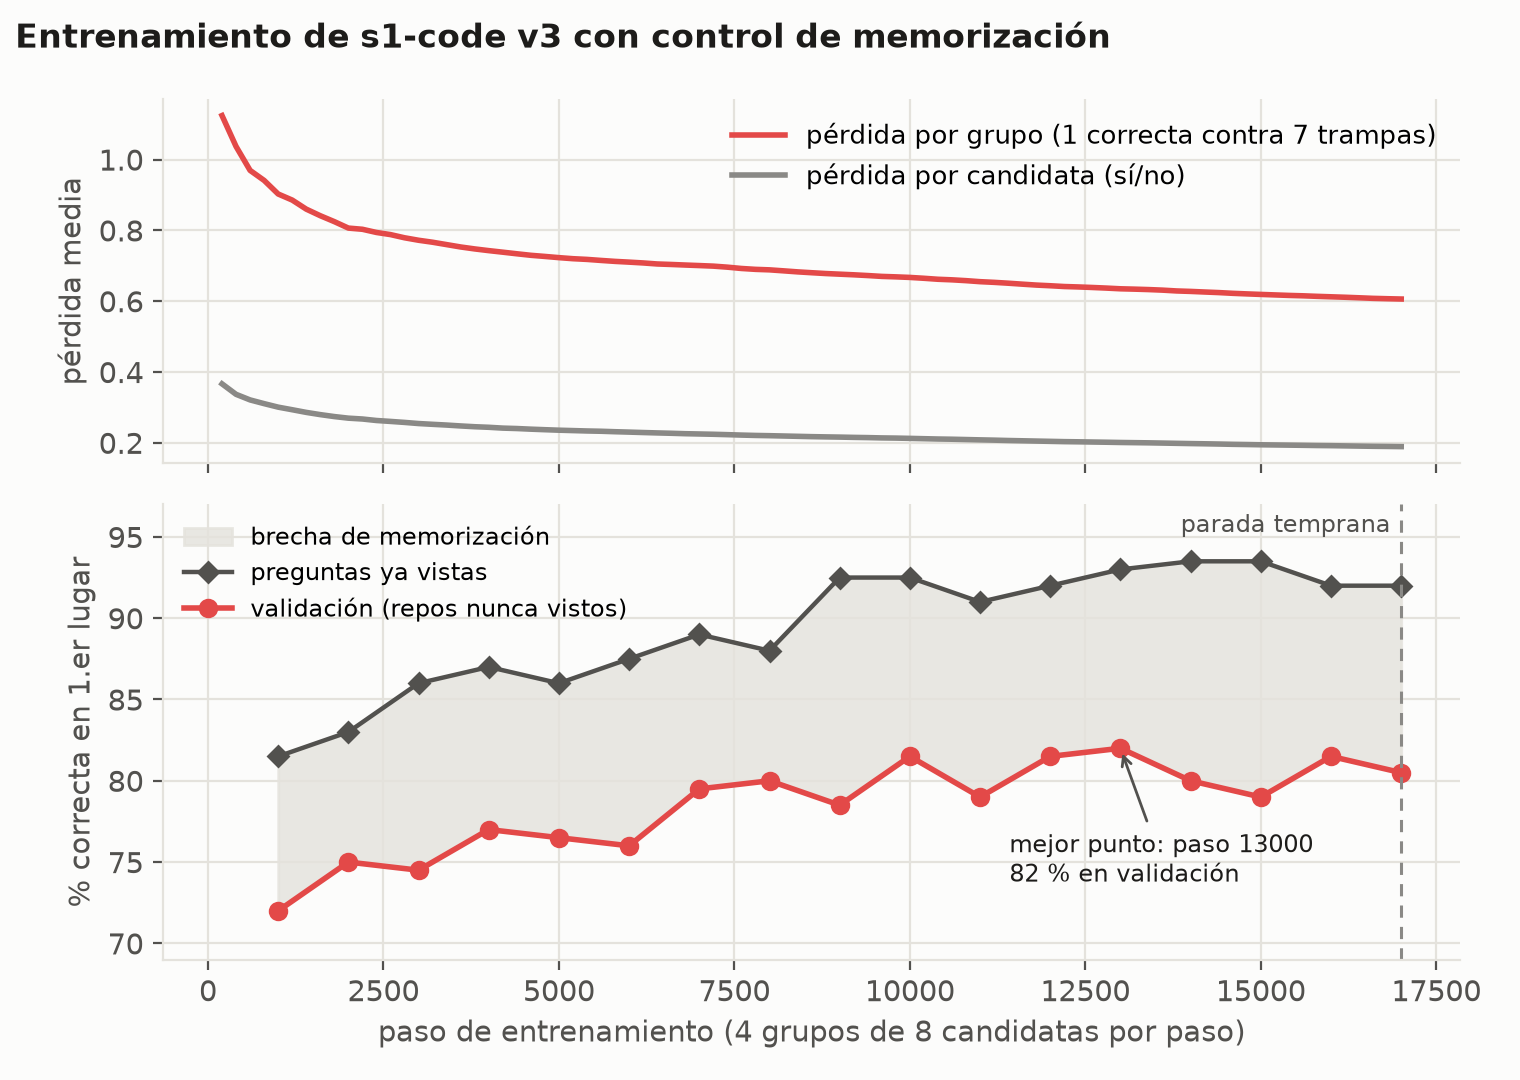
Para medirla, agentes escribieron un test nuevo de 197 preguntas sobre funciones que no aparecían en ningún examen anterior. Se abrió una sola vez, con la predicción escrita antes.
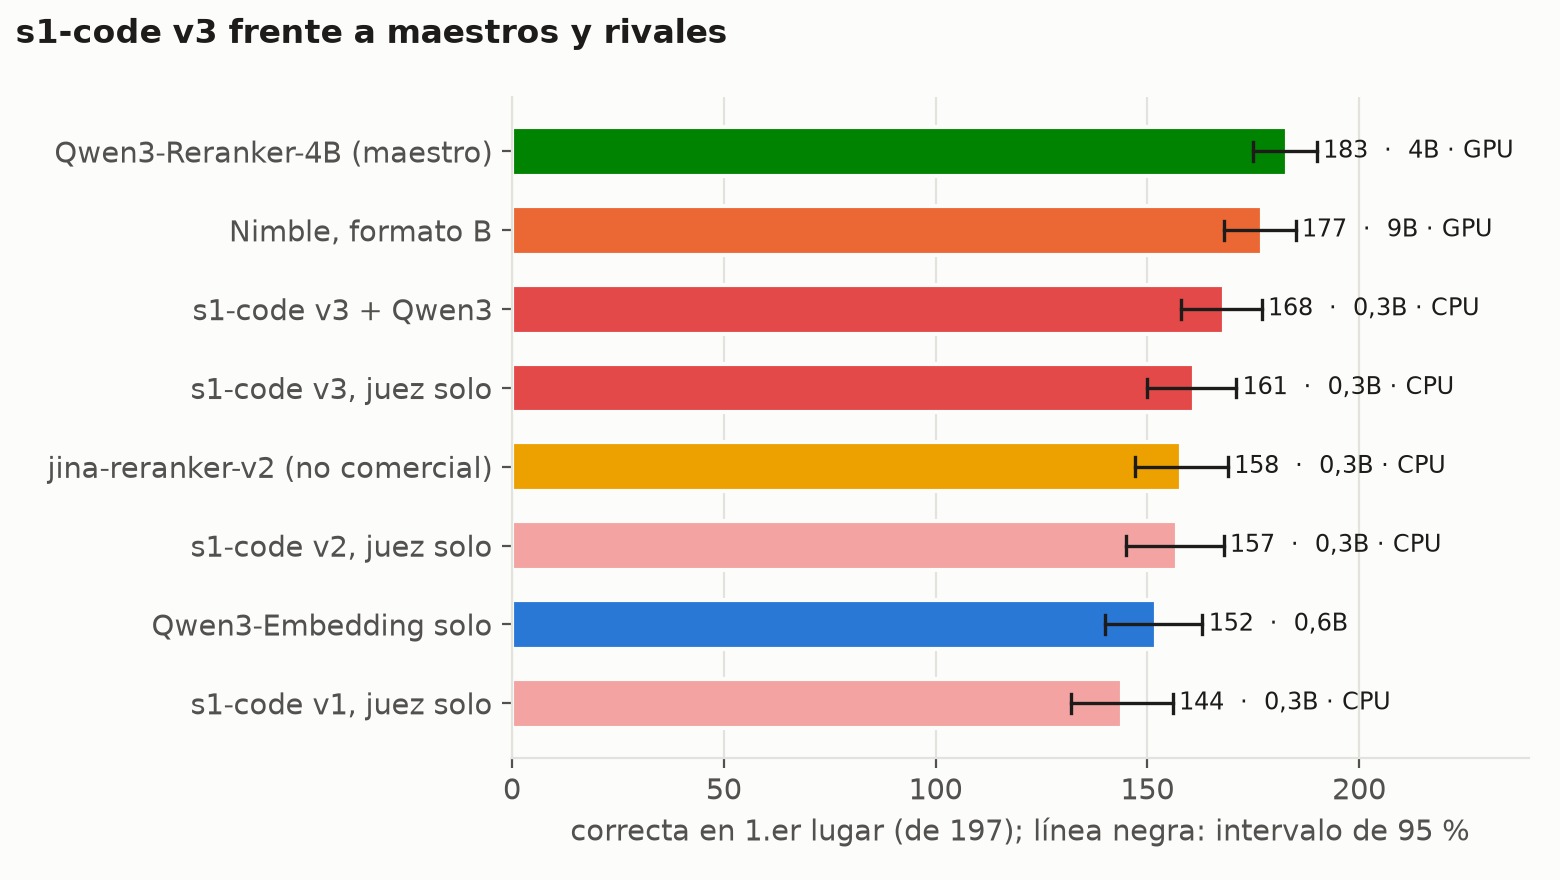
| Sistema | Tamaño | 1.er lugar (de 197) | Inglés | Español |
|---|---|---|---|---|
| Qwen3-Reranker-4B (maestro) | 4 000M · GPU | 183 | 91 % | 95 % |
| Nimble | 9 000M · GPU | 177 | 90 % | 90 % |
| s1-code v3 + Qwen3-Embedding | 322M · CPU | 168 | 85 % | 85 % |
| s1-code v2 + Qwen3-Embedding | 322M · CPU | 165 | 83 % | 84 % |
| s1-code v3, juez solo | 322M · CPU | 161 | 82 % | 81 % |
| jina-reranker-v2 (no comercial) | 278M · CPU | 158 | 78 % | 82 % |
| Qwen3-Embedding solo | 600M | 152 | 76 % | 78 % |
| s1-code v1, juez solo | 322M · CPU | 144 | 68 % | 78 % |
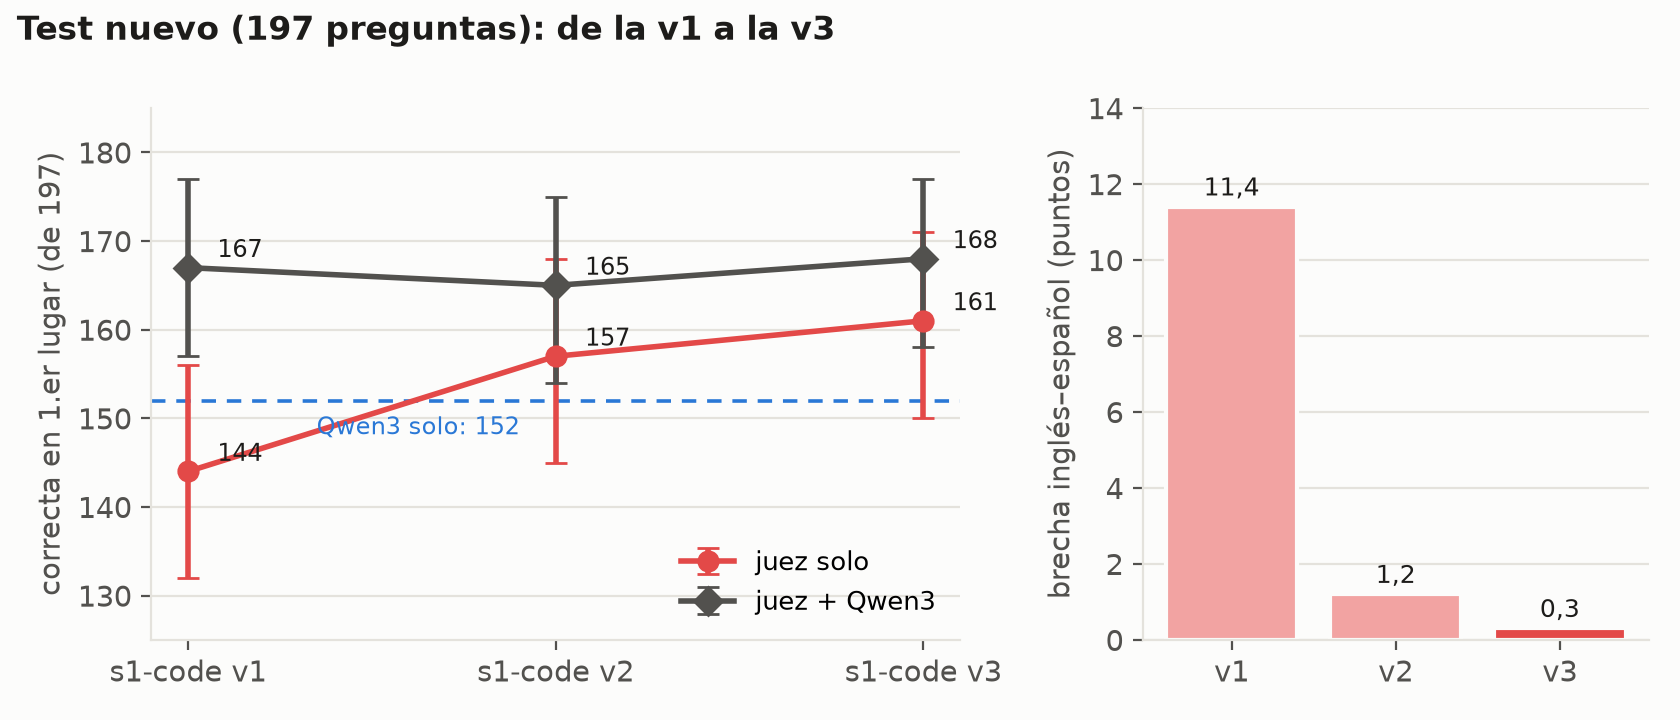
Contra la regla fijada antes: la v3 debía ganarle con seguridad a la v2 y a Qwen3 solo. Le gana a Qwen3 solo (p = 0,0015) pero no a la v2 (p = 0,65). La regla completa no se cumplió, tal como anticipaba la predicción escrita (alrededor de 30 % de probabilidad).
Fase 7 · s1grep: el producto
Con el modelo congelado, construimos el buscador alrededor de él. Funciona en cuatro pasos, todos en tu CPU:
- Indexar: tree-sitter parte cada archivo en funciones y métodos; granite convierte cada una en un vector y se guarda en SQLite, fuera del repositorio. Solo se vuelven a leer los archivos que cambiaron.
- Buscar: la pregunta se convierte en vector y salen las 25 funciones más cercanas.
- Juzgar: s1-code v3 lee las 5 primeras y responde con una probabilidad.
- Combinar: el orden del juez y el del buscador se fusionan con pesos elegidos en dev, nunca en test.
Velocidad
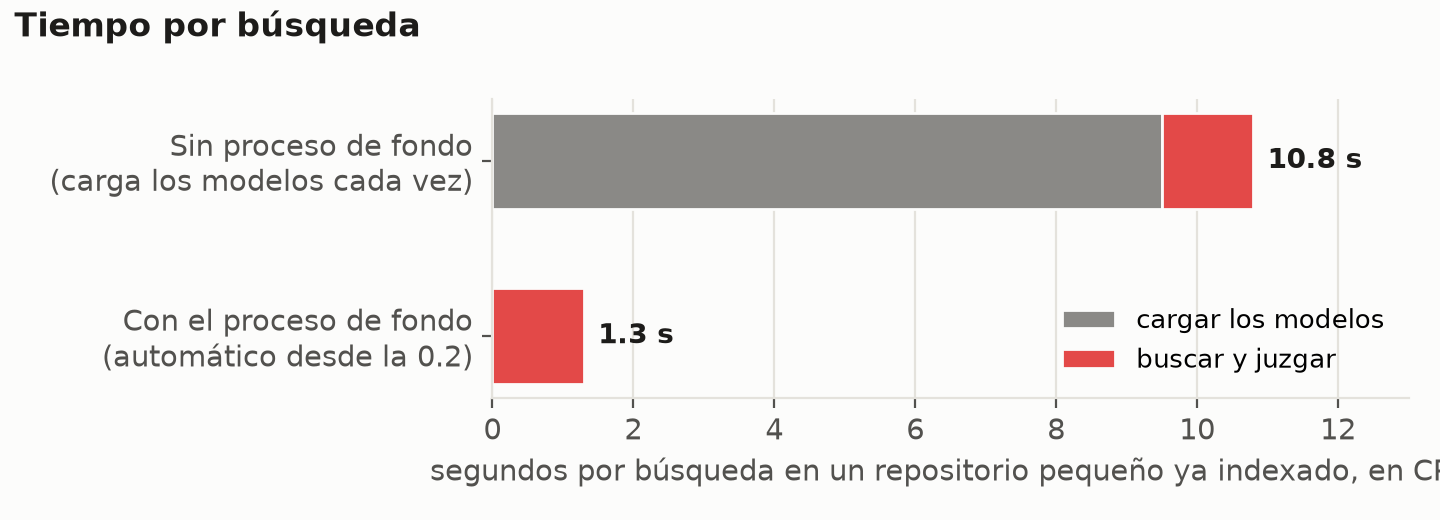
Recortar lo que lee el juez a 256 o 192 tokens lo hace más rápido, pero baja el acierto por debajo de no usarlo, porque se entrenó leyendo 384. Lo que sí funcionó fue juzgar las candidatas una por una en vez de en lote (25 % más rápido, mismas respuestas) y dejar los modelos cargados en memoria.
Cómo se usa
s1grep setup                                     # descarga los modelos, una sola vez
s1grep "dónde se reintenta un pago fallido" .    # buscar
s1grep index .                                   # indexar un repositorio grande y seguir el progreso
s1grep status                                    # qué está cargado y cuánto está indexado
s1grep mcp                                       # herramientas para agentes: search_code e index_status
s1grep skill --install                           # guía de uso para Claude Code
Es un solo binario para Linux y Windows, sin Python. Nadie tiene que arrancar ni detener nada: la primera búsqueda levanta un proceso en segundo plano que solo escucha en tu máquina, con una clave que únicamente tu usuario puede leer, y se apaga tras 30 minutos sin uso.
Fase 8 · ¿Sirve para otros lenguajes?
s1-code se entrenó solo con Python. Para saber si sirve en otros lenguajes, armamos un examen con CodeSearchNet: 100 búsquedas por lenguaje sobre repositorios públicos, con granite trayendo las candidatas del mismo repositorio.
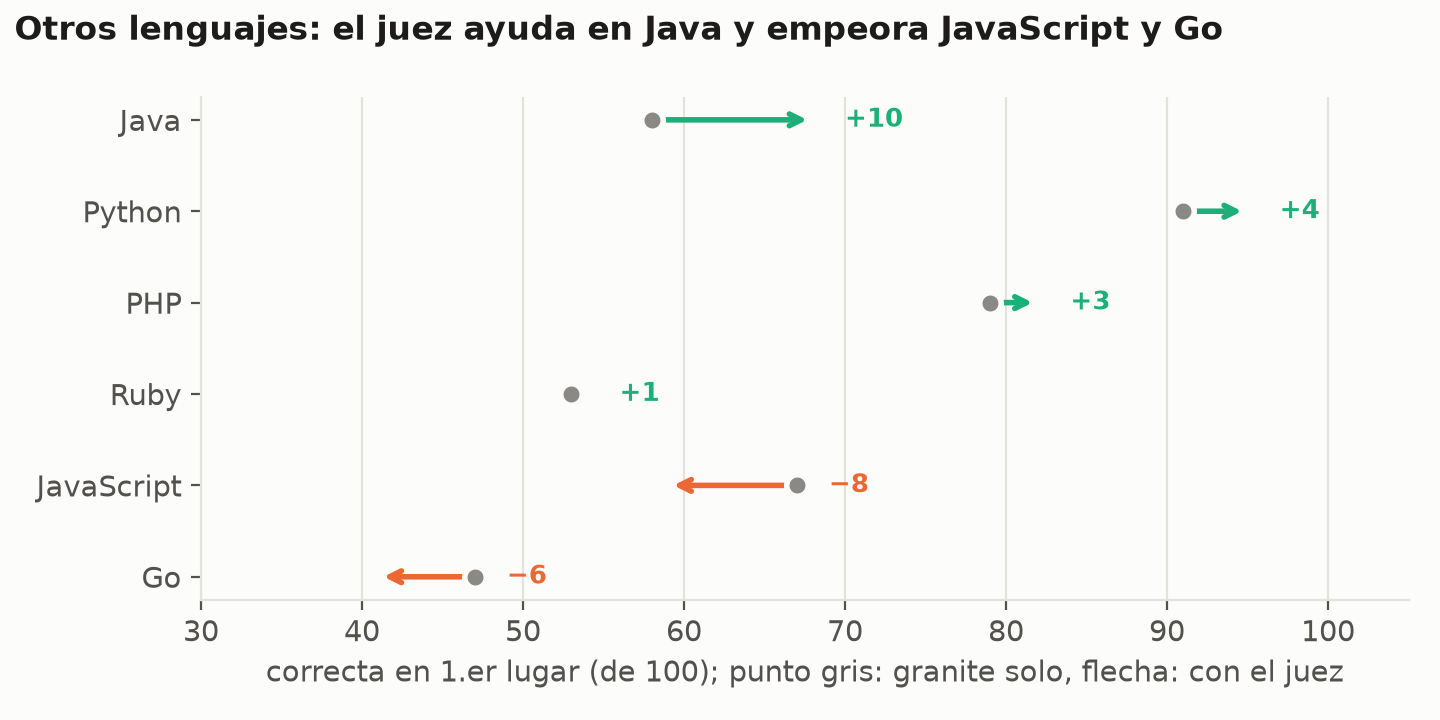
Nuestra predicción, escrita antes, decía que ningún lenguaje quedaría por debajo de granite solo. Falló en dos. La primera versión de s1grep se limitó a Python; desde la 0.2.6 lee nueve lenguajes con el mismo juez y esta tabla queda publicada para que cada uno sepa qué esperar. La solución de fondo es un juez entrenado con varios lenguajes.
Fase 9 · De prototipo a producto (s1grep 0.2 a 0.5)
La versión 0.1 demostraba la idea, pero en un repositorio grande la primera búsqueda podía tardar minutos, había que arrancar un servidor a mano y solo entendía Python. Antes de seguir añadiendo funciones, escribimos la arquitectura del producto, sus decisiones documentadas y una regla para todo cambio: el examen de 201 búsquedas no puede bajar. En las cinco versiones siguientes se mantuvo en 168.
Repositorios grandes: buscable en minutos
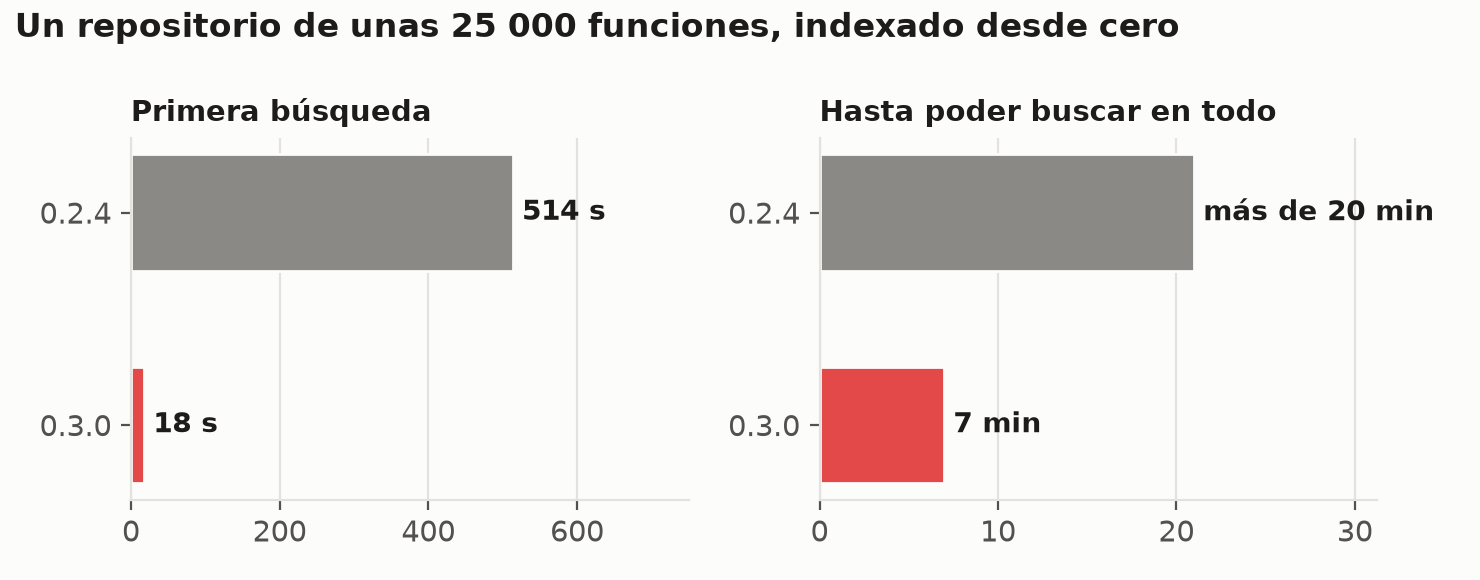
Indexar el código completo de cada función cuesta unos 5 a 10 por segundo en CPU: un repositorio de 25 000 funciones toma horas. La solución fue indexar en dos pasadas. Primero un esquema de cada función (ruta, nombre y primeras líneas), que basta para buscar en todo el repositorio; después, en segundo plano, el código completo, que es el que da la calidad final. Las búsquedas responden desde el primer momento y avisan cuánto del repositorio se puede buscar todavía.
| Esquemas con | 1.er lugar (de 201) | Entre los 5 primeros | Velocidad |
|---|---|---|---|
| granite 278M, el modelo principal | 135 | 167 | 1× |
| granite 97M, un modelo más pequeño | 133 | 166 | 3,3× |
Para los esquemas, un modelo tres veces más pequeño rinde casi igual, así que s1grep usa los dos: el pequeño para la primera pasada y el principal para la final. Con el repositorio completo, la búsqueda es exactamente la de antes.
Nueve lenguajes
Cada lenguaje es una consulta de tree-sitter de pocas líneas que indica qué es una función y cómo se llama su contenedor (una clase, un impl de Rust, el receptor de un método en Go). Sumar un lenguaje no toca el resto del código. Python conserva el extractor con el que se entrenó y examinó el modelo, para que sus resultados no cambien.
Buscar por palabras solo donde ayuda
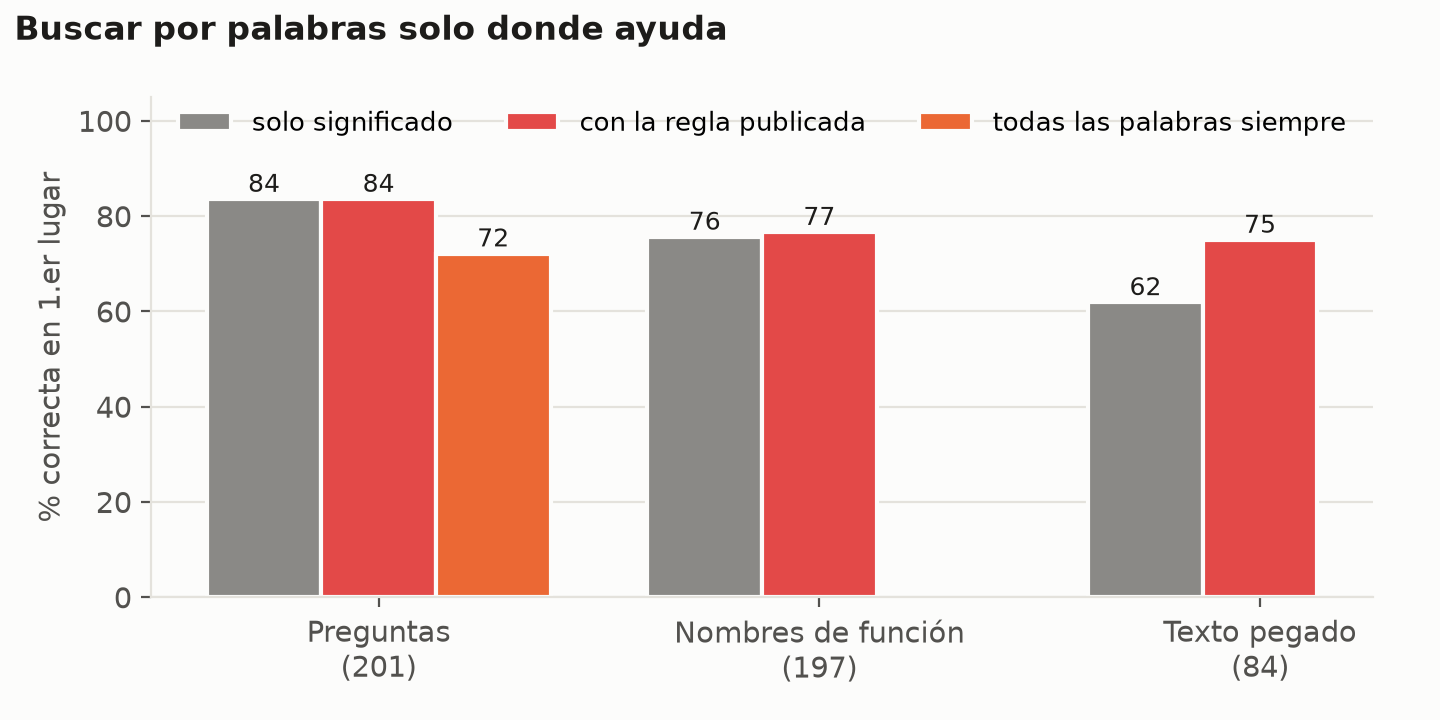
La búsqueda por significado falla con lo que se busca literalmente: un nombre exacto (parse_config) o un mensaje de error copiado de un log. Para eso cada repositorio tiene también un índice por palabras (BM25), con un tokenizador hecho para código que separa camelCase y snake_case y no depende de ningún idioma humano.
Usarlo en todas las búsquedas empeoró el examen: una pregunta en español comparte pocas palabras con código escrito en inglés, así que la lista por palabras solo metía ruido. La regla publicada decide por la forma de la consulta: si parece código, cuentan todas sus palabras; si es una frase, solo las coincidencias exactas.
Un juez que se detiene cuando está seguro
El juez lee las candidatas en orden y cada lectura cuesta unos 0,4 segundos. Si una supera el 90 % de probabilidad, no hace falta leer las siguientes.
| El juez lee | 1.er lugar (de 201) | Lecturas por búsqueda |
|---|---|---|
| Siempre las 5 | 168 | 5,0 |
| Hasta que una supera el 90 % | 168 | 3,3 |
| Hasta que una supera el 80 % | 166 | 2,8 |
| Siempre solo 3 | 165 | 3,0 |
Para agentes de programación
El proceso en segundo plano usa dos hilos: uno responde al instante (saber si está vivo, su estado, detenerlo) aunque el otro esté buscando o indexando, y una búsqueda abandonada por su cliente se cancela. Por MCP, los agentes tienen dos herramientas: search_code, con paginación, avisos de cobertura y notificaciones de progreso, e index_status. El protocolo, las decisiones de arquitectura y los exámenes están documentados en el repositorio.
Lo que probamos y descartamos
Cada idea se midió con el mismo examen antes de entrar. Estas no pasaron:
| Idea | Resultado | Decisión |
|---|---|---|
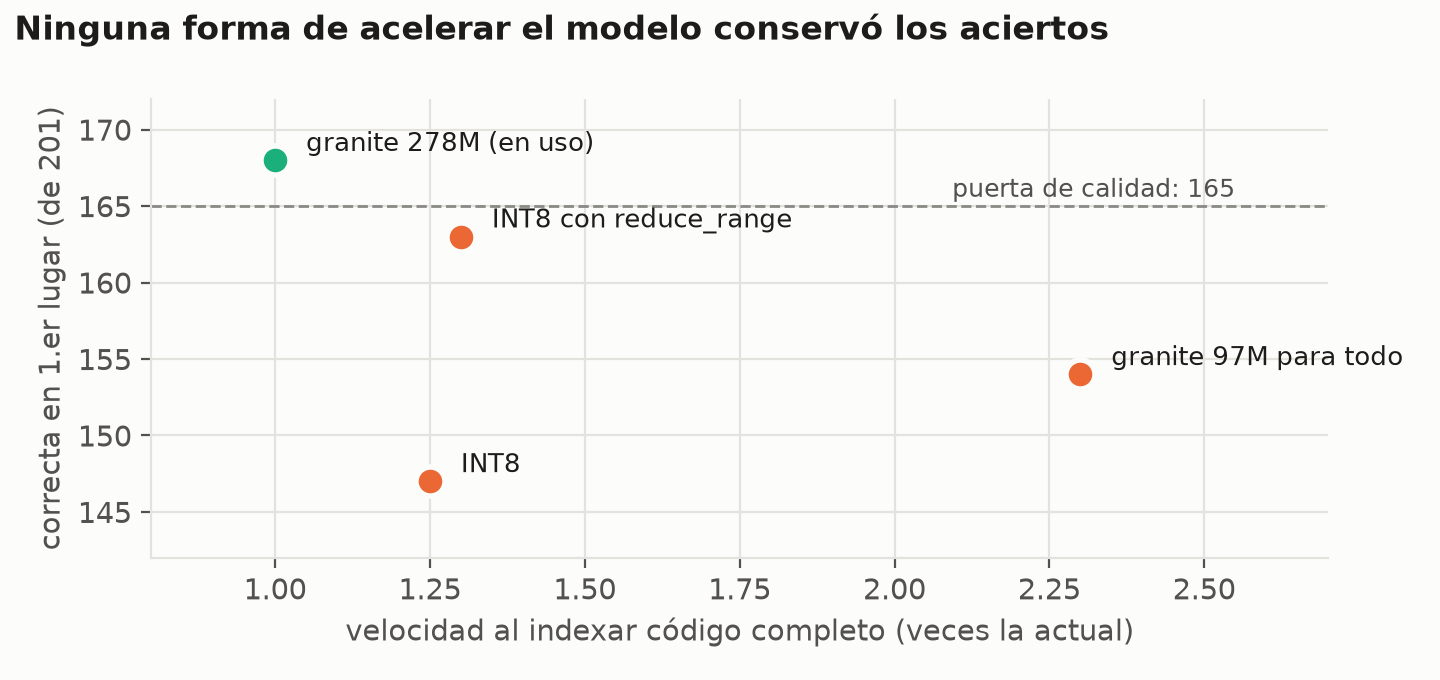
| Pesos en INT8 para el modelo de búsqueda | 1,3× más rápido, 163 de 201 en el mejor caso | Descartada |
| El modelo pequeño también para el código completo | 2,3× más rápido, 154 de 201 | Solo para esquemas |
| Esquemas de 2 líneas en vez de 4 | Igual de rápidos, 129 de 201 en vez de 135 | Descartada |
| Leer menos tokens por función | La función típica tiene unos 160 tokens: recortar a 384 ahorra 6–10 % | Descartada |
| Dos jueces en paralelo | Cada lectura pasa de 0,39 s a 1,06 s: la CPU está limitada por la memoria, no por los núcleos | Descartada |
| Buscar por palabras en todas las consultas | 145 a 155 de 201, sobre todo por las preguntas en español | Solo con la regla |
| Priorizar palabras raras de la pregunta que aparecen en nombres de funciones | Arreglaba la búsqueda que la inspiró y bajó el examen a 141 de 201 | Descartada |
| Vigilar los archivos con un watcher | Detectar cambios ya cuesta unos 110 ms de búsquedas de 1,3 a 2 s | No se construyó |
La penúltima merece una nota: es fácil diseñar una regla mirando la búsqueda que falló y convencerse de que mejora el producto. Arreglaba ese caso y rompía 27 aciertos de otros. Por eso ninguna regla entra sin pasar por el examen.
Lecciones de método
- Medir antes de construir. Una prueba de 20 preguntas evitó construir sobre un modelo que no servía.
- Cada implementación nueva necesita su prueba de paridad. ONNX, Rust, Windows e INT8 "cargaban sin error"; solo la comparación con el original mostró cuáles daban lo mismo.
- El examen no debe escribirse leyendo la respuesta. Las preguntas escritas mirando el código favorecían a la búsqueda por palabras.
- Revisar muestras antes de escalar. Dos muestras de 50 preguntas corrigieron defectos que habrían contaminado 36 000.
- Un juez tiene que ganarle al rival barato más fuerte. Superar al más débil parecía un éxito y no lo era.
- Escribir la predicción antes del resultado y abrir el test una sola vez. Con 100 preguntas, 9 aciertos de diferencia pueden ser azar.
- Desglosar antes de celebrar. Un salto de 269 a 315 venía entero de un atajo del conjunto de datos.
- Vigilar la memorización mientras se entrena, no después, y quedarse con el mejor punto.
- Elegir al maestro con una prueba. El modelo más llamativo no fue el mejor.
- Diseñar para que la nube falle. El proveedor apagó GPUs dos veces a mitad de una corrida; guardar cada resultado al llegar convirtió eso en minutos perdidos, no en horas.
- Una regla que arregla un caso puede romper cuarenta. Toda mejora se mide con el examen completo, nunca con el ejemplo que la inspiró.
- Medir lo publicado, no lo que crees haber publicado. Un valor cambiado por error dejó los esquemas en 2 líneas durante dos versiones; solo el examen lo destapó.
- Las cifras publicadas de un modelo no sustituyen a tu examen. Un modelo con mejores resultados en los benchmarks públicos de código perdió 14 búsquedas en el nuestro.
Límites y costos
- Los exámenes tienen 200 preguntas: detectan diferencias de unos 10 aciertos, no menores.
- Si el buscador no trae la función correcta entre las candidatas, el juez no puede rescatarla.
- Los modelos grandes con GPU siguen siendo mejores jueces; s1-code gana en tamaño, CPU, paridad de idioma, licencia y privacidad.
- En un repositorio grande, todo queda buscable en minutos, pero la calidad final (el código completo de cada función) tarda más: en una CPU, unas 5 a 10 funciones por segundo.
- El juez se entrenó con Python: en otros lenguajes y en código de dominios muy específicos da probabilidades bajas, y todavía no sabe decir con seguridad que la respuesta no está en el repositorio.
- Los repositorios privados usados para el examen y parte del entrenamiento no se publican; se describen solo en conjunto.
- Todavía no medimos el efecto en un agente real (tokens o tiempo ahorrados), que es la comparación que hace jevgrep.
| Costo de GPU en la nube | USD (estimado) |
|---|---|
| s1-code v1: preguntas, vectores, entrenamiento (L4) y evaluación | 4–5 |
| s1-code v2: preguntas (4 L4), vectores, entrenamiento (A100, 64 min) y evaluación | 10–11 |
| s1-code v3: vectores, maestro 4B, prueba de rivales, entrenamiento (A100, 73 min) | 8–10 |
| s1grep: desarrollo y todas las mediciones en CPU | 0 |
| Total | 22–26 |
Lo que sigue
- s1-code v4: un juez generalista entrenado con varios lenguajes desde el inicio, con el mismo método y las mismas reglas de examen.
- Saber decir "no está aquí": un examen con preguntas cuya respuesta no existe en el repositorio y un juez calibrado para reconocerlas. Es lo que más valor tendría para un agente: dejar de buscar donde no hay nada.
- Medir con agentes reales, con las mismas tareas que usa jevgrep: cuántos archivos lee y cuántos tokens gasta un agente con y sin s1grep.
Cada versión se publica solo si le gana a la anterior en el examen. Si no, se cuenta igual.
Recursos
HUGGING FACE
s1-code v3 · recomendado
Pesos, versión ONNX y model card.
GITHUB
s1grep
Código en Rust, binarios y documentación.
HUGGING FACE
s1-code v2
Paridad exacta de idioma.
HUGGING FACE
s1-code v1
La primera versión.
Referencias
- Laya (Convai Innovations, Apache 2.0), el modelo base.
- jevgrep y layagrep, las herramientas de referencia.
- granite-embedding-278m-multilingual y granite-embedding-97m-multilingual-r2 (IBM), y Qwen3 Embedding y Reranker.
- tree-sitter y tantivy, para leer el código y buscar por palabras.
- CommitPackFT, SWE-bench, SWE-Gym, SWE-smith, CoSQA y CodeSearchNet.
¿Quieres aplicar IA en tu empresa sin enviar tus datos a la nube?
En API SERVICE SAC aplicamos IA conectada a tus sistemas, medida con tus propios datos.
Conversemos